版本 v1 · 2026-10-06
材料:
- ECOC 2026 现场讲稿〔0921-Mo4-Cerebras,Jean-Philippe Fricker(联合创始人、首席系统架构师)〕;
- Hot Chips 2026 披露与 Cerebras 官方材料;
- SEC 文件(S-1、Q2 2026 8-K);
- 媒体与分析机构报道。
标记: 【官方】【本地】【机构】【推算】。
相关笔记:
0. 结论
- Cerebras 卖的是”每用户速度”,不是”每瓦并发”。
- 一片晶圆有 44 GB SRAM、43.2 PB/s 带宽,把整片内存扫一遍只要约 1 µs;Rubin 和 Jalapeño 扫一遍 HBM 约 13–14 ms,相差约 1.3 万倍【推算】。
- 所以它的单用户解码速度极高:GPT-5.6 Sol 达到 750 tok/s,Llama 4 Scout 达到 2,600 tok/s。
- 代价是容量:CS-4 整个机架只有 132 GB,约为 Rubin NVL72 的 1/157。KV cache 的空间很紧,并发会话数少。
- CS-4(2026 年 8 月)只是”同一颗芯片跑快一倍、三片装一个机架”。
- WSE-3T 工艺不变(5 nm),时钟翻倍;单晶圆功耗估计约 54 kW。
- 晶圆之间是电互连,每片 2.4 Tb/s、2 µs,串成链。
- 真正改变容量结构的是 CS-6(晶圆 SRAM + 3D 叠层 DRAM);CS-5(2027 年)是新一代 WSE。
- 商业上已经从”阿联酋单一客户的硬件公司”转成”推理云公司”。
- 2025 年营收 5.1 亿美元,其中 86% 来自 MBZUAI 和 G42。
- 2026 年 5 月 IPO,募资 64 亿美元(含超额配售),估值约 564 亿美元。
- Q2 2026:云业务同比 +281%;剩余履约义务(RPO)254 亿美元;签约数据中心容量 600 MW 以上。
- 支柱客户:OpenAI 750 MW(价值 200 亿美元以上)和 AWS(Trainium3 做 prefill、CS-3 做 decode)。
- 对网络和光的含义:
- 晶圆把 TP 和 EP 流量吞进了片上 fabric,片外只走 PP 激活值,所以 scale-up 网络需求反而很小。
- 但”片上 53.5 PB/s 对片外 300 GB/s”相差约 18 万倍。CS-6 加大容量后并发会上升,PD 分离又要求 KV 快速灌入晶圆,这两点会把瓶颈推到晶圆 I/O 上。
- Cerebras 在 ECOC 上把”光学晶圆混合键合”列为方向,现阶段仍是可插拔光模块(RoCE)加电直连。
1. 产品谱系
| 代际 | 年份 | 工艺 | 晶体管 | 核数 | 片上 SRAM | 内存带宽 | 算力 | 系统 | 来源 |
|---|---|---|---|---|---|---|---|---|---|
| WSE-1 | 2019 | TSMC 16 nm | 1.2 万亿 | 40 万 | 18 GB | 9 PB/s | — | CS-1 | 【官方】 |
| WSE-2 | 2021 | 7 nm | 2.6 万亿 | 85 万 | 40 GB | 20 PB/s | — | CS-2 | 【官方】 |
| WSE-3 | 2024 | 5 nm | 4 万亿 | 90 万 | 44 GB | 21 PB/s | 125 PF(稀疏 FP16) | CS-3,约 27 kW | 【官方】 |
| WSE-3T(Turbo) | 2026-08 | 5 nm | 4 万亿 | 90 万 | 44 GB | 43.2 PB/s | 250 PF | CS-4:3 片 / 机架,约 54 kW / 片 | 【官方】;功耗为【机构】STH 估算 |
| CS-5(新 WSE) | 2027 目标 | 未披露 | — | — | — | — | — | 目标见 §5 | 【官方】 |
| CS-6 | 2024 年起研发 | — | — | — | 晶圆 SRAM + 3D 叠层 DRAM | — | — | 占地小一个数量级 | 【官方】【本地】 |
共同点:
- 晶圆面积约 46,225 mm²(约 215 mm × 215 mm),一整片 300 mm 晶圆切出一个方形。
- 每个核配本地 SRAM:WSE-3 为 44 GB ÷ 90 万 ≈ 48 KB / 核【推算】。
- 核之间是 2D mesh 数据流 fabric,靠冗余核加路由绕开缺陷来保证良率。
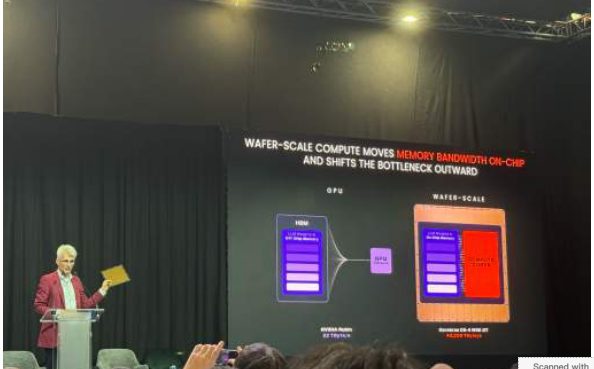 ECOC 2026〔0921-Mo4-Cerebras p4〕:GPU 的内存带宽在 HBM 与计算之间的接口上(标注 Rubin 22 TB/s);晶圆级把内存放在计算旁边(标注 CS-4 WSE-3T 43,200 TB/s),瓶颈被推到晶圆外。
2. WSE-3T 与 CS-4 详细规格
2.1 单晶圆(WSE-3 → WSE-3T)【官方 / 机构】
| 指标 | WSE-3 | WSE-3T | 变化 |
|---|---|---|---|
| 稀疏 FP16 | 125 PF | 250 PF | ×2(时钟翻倍) |
| 内存带宽 | 21 PB/s | 43.2 PB/s | ×2 |
| 片上 fabric | 26.8 PB/s | 53.5 PB/s | ×2;Cerebras 称约为 Rubin NVL72 整机架 NVLink(260 TB/s)的 200 倍 |
| 对外网络 | 150 GB/s | 300 GB/s(2.4 Tb/s) | ×2 |
| 功耗 | 约 27 kW | 约 54 kW(STH 估算) | 约 ×2 |
| 工艺 / 晶体管 / 核 / SRAM | 5 nm / 4 万亿 / 90 万 / 44 GB | 同左 | 不变 |
2.2 CS-4 机架(Nexus 平台)【官方】
| 项目 | 内容 |
|---|---|
| 组成 | 3 个计算”背包”(backpack),每个装 1 片 WSE-3T,并自带供电、冷却和 I/O;前部是电源机架,背包现场插装 |
| 合计 | 750 PF;132 GB SRAM;129.6 PB/s 内存带宽;160.5 PB/s fabric;I/O 900 GB/s(7.2 Tb/s) |
| 晶圆间互连 | 每片 2.4 Tb/s;时延最低 2 µs;链式拓扑;电学直连 |
| 切分方式 | 执行流水线化,大流量的张量和专家通信留在晶圆内,只让激活值跨晶圆 |
| 供电 | AC/DC 转换器离晶圆约 0.5 mm(Cerebras 称比 GPU 近 100 倍);输入最高 277 V AC,输出 54.5 V DC;每背包最多 30 个风冷 PSU;冗余 5+1 / 4+1 / 3+1 / 4+2 |
| 冷却 | 每背包有独立水处理系统;干式快插阀,换背包不用排液;有漏液和冷凝传感器 |
| 相对 CS-3 | 每背包供电和冷却能力 ×2、部件少 50%;token 数 ×2;每瓦 token 约 ×10(官方口径) |
机架功耗【推算】:
- 3 × 约 54 kW ≈ 162 kW,加上外围约 180 kW(IT)。
- 与 GB300 NVL72(约 135–140 kW)和 Jalapeño ASIC 机架(约 130 kW,另配 31–50 kW 主机机架)同一量级。
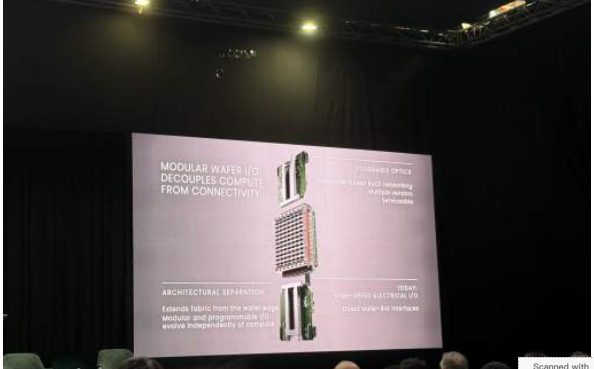 ECOC〔p7〕:“模块化晶圆 I/O 让计算与连接解耦”。今天用高速电 I/O 直连晶圆;对外用基于标准 RoCE、多厂商、可维护的可插拔光模块;I/O 从晶圆边缘延伸出去,和计算各自演进。
3. 机理:为什么快,代价在哪里
3.1 关键比值:带宽 ÷ 容量【推算】
“带宽 ÷ 容量”就是”把整片内存读一遍需要多久”。在 batch=1 的解码中,这直接决定每用户速度的上限。
| 平台 | 单芯片容量 | 单芯片带宽 | 扫一遍用时 | 单机架容量 | 单机架带宽 |
|---|---|---|---|---|---|
| Cerebras WSE-3T / CS-4 | 44 GB | 43.2 PB/s | 约 1 µs | 132 GB | 129.6 PB/s |
| NVIDIA Groq 3 LPU / LPX | 0.5 GB | 150 TB/s | 约 3.3 µs | 128 GB | 约 40 PB/s |
| Vera Rubin / NVL72 | 288 GB | 22 TB/s | 约 13 ms | 20.7 TB | 约 1.6 PB/s |
| OpenAI Jalapeño / 128 颗机架 | 216 GB | 15.4 TB/s | 约 14 ms | 27.6 TB | 约 2.0 PB/s |
| GB300 / NVL72 | 288 GB | 8 TB/s | 约 36 ms | 20.7 TB | 约 0.58 PB/s |
解读:
- CS-4 机架的内存带宽约为 Rubin NVL72 的 82 倍,容量约为其 1/157。
- 机架容量与 Groq 3 LPX 几乎相同(约 130 GB),带宽约为 LPX 的 3 倍。两者属于同一条”SRAM 放模型”路线。
- HBM 路线(Rubin、Jalapeño)靠大容量换来高并发,Cerebras 和 Groq 靠小容量换来极高单用户速度。
3.2 模型放得下吗:权重占用【推算】
假设每片约 35 GB 可用于权重,其余留给 KV 和激活。
| 模型 | 精度 | 权重 | 晶圆数 | CS-4 机架数 |
|---|---|---|---|---|
| gpt-oss-120B | MXFP4 | 约 61 GB | 2 | 1 |
| Llama 3.1 405B | FP16 | 约 810 GB | 约 23 | 约 8 |
| 1T 参数 MoE(Kimi K2.5 类) | FP8 | 约 1.0 TB | 约 29 | 约 10 |
| 1T 参数 MoE | FP4 | 约 0.55 TB | 约 16 | 约 6 |
- 公开报道:Llama 405B 用 12 台 CS-3 达到约 350 tok/s(早期估计);官方实测达到 969 tok/s【官方】。
- 前沿闭源模型(GPT-5.6 Sol 一类)参数规模未公开。按万亿级估算,一个模型实例就要占用数个到十几个 CS-4 机架。
3.3 KV cache:真正的约束【推算】
以 1T FP4 MoE 占 16 片晶圆为例:
- SRAM 合计 704 GB,扣掉 550 GB 权重,剩约 150 GB 给 KV 和激活。
- 128K 上下文按 70 KB/token 算,每个会话约 9 GB。
- 结果:约 16 片晶圆(约 6 个机架、约 1 MW)只能同时容纳十几个长上下文会话。
- 对照:一个 Jalapeño 机架约能容纳 3,000 个 128K 会话(见 Jalapeño 笔记 §5.2)。
由此推出:
- 定价: Cerebras 只适合做溢价的”Ultrafast”档,按单用户速度收费,而不是按吞吐。OpenAI 的 Ultrafast 档价格约为标准档的 6 倍。
- 与 Agent 负载的矛盾: SemiAnalysis 统计的 Agent 负载里,上下文常在 10 万到 100 万 token。长上下文越多,Cerebras 能服务的并发越少。
- 为什么做 CS-6: 加 3D DRAM,就是为了扩大 KV 容量又不牺牲局部性。
- 为什么和 AWS 做 PD 分离: prefill 交给 Trainium3,晶圆只做 decode。但 decode 时 KV 仍要放在晶圆的 SRAM 里,所以容量约束依然存在。
3.4 流水线与时延【推算】
每 token 时间预算:
- 750 tok/s ≈ 每 token 1.33 ms。
- 模型如果串在 16 片晶圆上,15 跳 × 2 µs = 30 µs,只占约 2%。时延主要花在晶圆内计算上(每片约 80 µs)。
跨晶圆流量很小:
- 只传隐藏层激活:例如 hidden 7,168 × 2 字节 ≈ 14 KB / token / 跳;
- 在 300 GB/s 上传输约 50 ns。
- 跨晶圆带宽不是瓶颈,跨晶圆时延也不是。
真正的约束是流水线利用率:
- 要让 16 级流水线都忙起来,至少需要 16 个微批同时在飞,而 KV 容量限制了并发。
- 所以单用户速度和每兆瓦吞吐存在此消彼长的关系。CS-5 设定的”每兆瓦每秒 300 万 token”就是针对这个问题的目标。
与 GPU 的流量模型对比:
- GPU 上 TP 和 EP 走 NVLink 或以太网 scale-up:每卡 TP 约 235 GB/step,EP 约 240 Gb/s(见流量调度报告)。
- 在 Cerebras 上,同样的流量全部在片上 fabric(53.5 PB/s)里完成。片外只剩 PP 激活、前端流量和 KV 灌入。
3.5 训练能力(历史与现状)【官方,2023–2024】
- 权重流式(weight streaming): 权重存在外部 MemoryX(最高 1.2 PB),通过 SwarmX 广播和规约,晶圆只保存激活。
- 规模宣称: 最多 2,048 台 CS-3、256 EFLOPS,可训练 24 万亿参数的模型。
- 实际部署: 与 G42 合建 Condor Galaxy,例如 CG-1 为 64 台 CS-2,CG-3 为 64 台 CS-3、约 8 EF。
- 判断: 训练市场由 NVIDIA 和 TPU 主导。Cerebras 2025 年以后的增量几乎全部来自推理云,训练能力主要是历史资产。
4. 商业落地(2025–2026)
4.1 财务与资本【官方:SEC / 公司公告】
| 项目 | 数值 |
|---|---|
| 2025 年营收 | 5.10 亿美元(+76%);MBZUAI 占 62%、G42 占 24%,合计 86% |
| IPO | 2026-05-14 在纳斯达克上市(CBRS),发行价 185 美元;基础募资 55.5 亿美元,含超额配售 64 亿美元;完全稀释估值约 564 亿美元;首日收盘 311.07 美元(+68%) |
| IPO 前融资 | 2026 年 2 月 H 轮 10 亿美元;2026 年 1 月 OpenAI 提供 10 亿美元营运资金贷款 |
| 营收(Q2 2026) | GAAP 1.801 亿美元,其中硬件 0.541 亿、云与服务 1.260 亿;Core 2.099 亿美元(同比 +103%) |
| 云业务增长 | GAAP +281%,Core +287% |
| 毛利率 | GAAP 14%,Core 41% |
| 净利润 | GAAP 亏损 4.505 亿美元;Core 亏损 690 万美元 |
| 剩余履约义务 | 254 亿美元 |
| 现金 | 86 亿美元,另有 8.5 亿美元循环信贷 |
| 数据中心 | 签约容量 600 MW 以上,2027 年底前交付;2026 年制造产能计划扩大 10 倍以上 |
| 2026 指引 | Core 营收 8.8–8.9 亿美元;Core 毛利率 41–43% |
4.2 客户与部署
| 客户 | 内容 | 来源 |
|---|---|---|
| OpenAI | 2025 年 12 月签主协议:750 MW 推理算力,2026–2028 年分批部署,价值 200 亿美元以上;另有到 2030 年追加 1.25 GW 的期权。2026-08-13 GPT-5.6 Sol 在”Ultrafast”档跑到 750 tok/s,比标准档快约 14 倍,先向受信任伙伴分批开放 | 【官方】 |
| OpenAI(反例) | 2026-09-29 发布的 GPT-6.1 Sol Ultrafast(约 300 tok/s,价格为标准档的 6 倍),SemiAnalysis 称它跑在 NVIDIA GPU(小 batch)上,不在 Cerebras;OpenAI 和 Cerebras 未回应 | 【机构】 |
| AWS | 多年合作,做”推理解耦”:Trainium3 负责 prefill,CS-3 负责 decode,两者通过 EFA 连接;2026 年晚些时候上 Bedrock(开源模型与 Amazon Nova);宣称同等占地吞吐 5 倍、速度最高 15 倍 | 【官方】 |
| Meta | Llama API,Llama 4 Scout 约 2,600 tok/s | 【官方】 |
| Mistral | Le Chat 约 1,100 tok/s(结合推测解码) | 【官方】 |
| 其他 | Cognition、Lovable(编程)、CrowdStrike;AMD(推理解耦合作);Block、Figma、AlphaSense、GSK | 【官方】 |
| 数据中心 | 2025 年宣布北美与欧洲 6 个新数据中心;Oklahoma City 部署 300 台以上 CS-3;Montreal 为自有自营;目标服务 4,000 万 Llama-70B tok/s | 【官方】 |
4.3 OpenAI 750 MW 折算多少硬件【推算】
- 每个 CS-4 机架约 180 kW(IT)。750 MW ÷ 0.18 MW ≈ 4,200 个机架、约 1.25 万片晶圆(若全按 CS-4 计;实际会混合 CS-5)。
- 1.25 万片 5 nm 晶圆分布在 3 年内,相对台积电 N5/N3 家族的产能微不足道。瓶颈不在晶圆,而在系统制造(背包、供电、液冷)、电力和机房。 这和 Cerebras”2026 年制造产能扩大 10 倍”的说法一致。
- 按 Q2 RPO 254 亿美元和 OpenAI 合同 200 亿美元以上计算,积压订单中约 80% 以上来自 OpenAI。客户集中风险从阿联酋转移到了 OpenAI。
5. 路线图:CS-5 与 CS-6
| CS-5(2027) | CS-6 | |
|---|---|---|
| 芯片 | 新一代 WSE | 晶圆级 SRAM 与计算 + 3D 叠层 DRAM(超高带宽连接) |
| 目标 | 开源模型(Gemma 4 31B、gpt-oss-120b)每用户最高 1 万 tok/s;前沿模型(Kimi、GPT-5.6 Sol)每用户最高 5,000 tok/s;每兆瓦每秒 300 万 token;支持 50 万亿参数以上的模型 | 大幅扩大内存容量,同时保留晶圆级的局部性;占地小一个数量级 |
| 平台 | Nexus(沿用 CS-4 的背包架构) | Nexus |
| 来源 | 【官方】Hot Chips 2026 | 【官方】【本地】ECOC p9:“Announced at HotChips’26” |
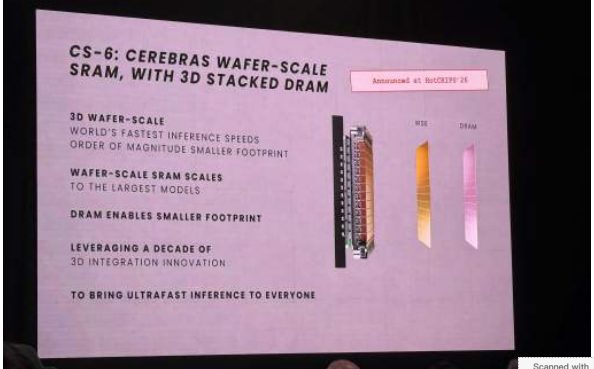 ECOC〔p9〕CS-6:晶圆级 SRAM 加 3D 叠层 DRAM。讲稿要点:3D 晶圆级,世界最快推理,占地小一个数量级;晶圆级 SRAM 可扩展到最大的模型;DRAM 让占地更小;借助十年 3D 集成积累。
判断:
- 有了 CS-6,“热权重和活跃 KV 在 SRAM、冷 KV 和长上下文在 DRAM”可以在同一个晶圆堆叠里完成。
- 这正是 SemiAnalysis 图 7 里”混合键合 3D RAM”那类方案,补上了 Cerebras 在容量和并发上的短板。
6. 与竞品对比
| 维度 | Cerebras CS-4 | NVIDIA Groq 3 LPX | OpenAI Jalapeño | NVIDIA Vera Rubin NVL72 |
|---|---|---|---|---|
| 内存 | 晶圆 SRAM,132 GB / 机架 | SRAM 500 MB × 256 = 128 GB / 机架 | HBM4 216 GB × 128 = 27.6 TB / 机架 | HBM4 288 GB × 72 = 20.7 TB / 机架 |
| 内存带宽 / 机架 | 129.6 PB/s | 约 40 PB/s | 约 2.0 PB/s | 约 1.6 PB/s |
| scale-up | 片上 fabric 53.5 PB/s;晶圆间 2.4 Tb/s 链式 | 未公开(静态调度 C2C) | 以太网 TH6,本地 128 / 全局 2,048 | NVLink 6,260 TB/s / 机架 |
| 定位 | 极速解码(也能做 prefill) | decode 专用,与 Rubin(prefill)配对 | 推理通用,prefill 与 decode 不拆分 | 训练加推理通用 |
| 每用户速度 | 750–2,600 tok/s(已上线);CS-5 目标 5,000–10,000 | 高(官方:配合 Rubin 每兆瓦吞吐 35 倍) | 约 700 tok/s / 用户(Kimi K2.5,自报) | GB300 MTP 上限约 330 |
| 并发 / 长上下文 | 弱(KV 容量) | 弱 | 强 | 强 |
| 供应链 | 台积电单一代工;独家晶圆级封装与系统 | 三星 4 nm;不用 HBM | 台积电 N3P + CoWoS + HBM4 | 台积电 + CoWoS + HBM4 |
格局判断:
- 2026–2027 年”极速解码”细分市场有三家正面竞争:Cerebras、NVIDIA(Groq 3 LPX)和 OLIX(2027 年)。
- NVIDIA 用 LPX 加 Rubin 把”prefill 用 GPU、decode 用 SRAM”变成自家套装,这是对 Cerebras 最大的威胁。
- GPT-6.1 Sol Ultrafast 据称没有跑在 Cerebras 上,说明大客户在多个平台之间选择。
7. 对网络与光互连的含义
- 今天:片外流量少,光的用量也少。
- 晶圆间链式电直连,每片 2.4 Tb/s;对外是可插拔光模块(RoCE、多厂商)〔ECOC p7〕。
- 一个 CS-4 机架的对外 I/O 只有 7.2 Tb/s,约等于 9 只 800G 模块【推算】。
- 同等功耗下,GPU 机架的 scale-up 与 scale-out 光需求高出几个数量级。
- 片内外带宽悬殊,问题在面积而不在边长。
- 片上 53.5 PB/s,片外 300 GB/s,相差约 1.8×10⁵ 倍。
- 晶圆周长约 860 mm,2.4 Tb/s 折合只有约 2.8 Gb/s/mm【推算】,远低于 CPO 1 Tb/s/mm 级的目标。
- 瓶颈不是边长不够,而是电信号从晶圆中心走到边缘的功耗和布线。所以 ECOC 讲稿提出在晶圆表面就近做电光转换,用低损耗波导把信号送到边缘,即按面积算带宽(BW/mm²),而不是按边长(BW/mm)。
- 两个会放大 I/O 需求的趋势【推算】:
- PD 分离(AWS 模式): 32K 上下文 × 70 KB ≈ 2.2 GB 的 KV 要从 Trainium 灌入晶圆。按 CS-4 每片 300 GB/s 算约 7 ms,CS-3 约 15 ms;128K 上下文要 30–60 ms。KV 灌入会成为 TTFT 的一部分,晶圆 I/O 需要提升一个数量级。
- CS-6 扩容: 容量上去后并发上升,跨晶圆激活流量和 KV 进出流量同比上升。
- 光学晶圆路线(ECOC 讲稿):
- 三层混合键合:光学晶圆 / WSE / DRAM。
- 五个设计维度:带宽密度、激光器位置、SerDes 重新优化、热兼容、可测试性与良率;另加可维护性与标准(p15)。
- 没有给出任何数值,是方向性表态。 收尾页把 CS-4、CS-5、CS-6 并列,标题为”混合键合打开通往晶圆级光 I/O 的路径”(p16)。
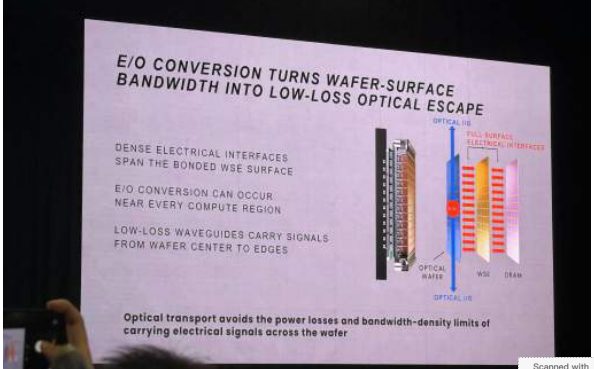
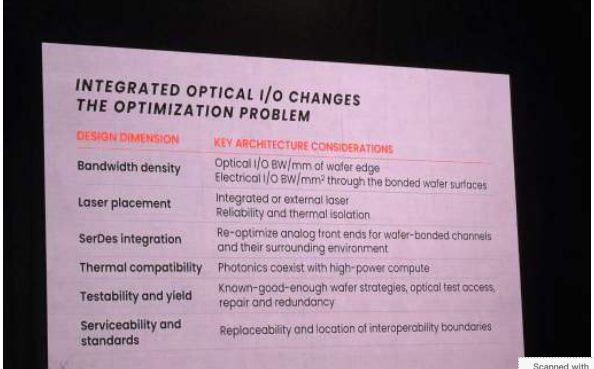
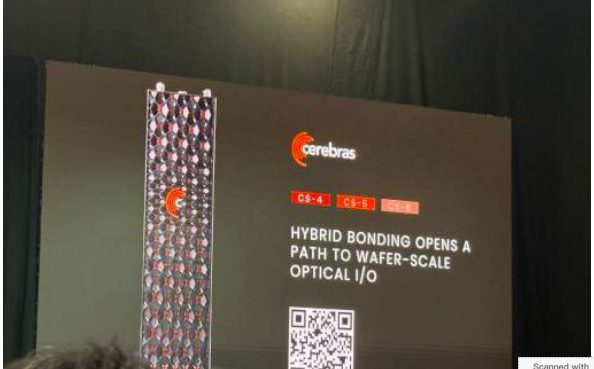 ECOC〔p13、p15、p16〕:晶圆表面电光转换与波导逃逸;集成光 I/O 的设计权衡;CS-4 → CS-5 → CS-6 路线。
8. 风险与待核实
| 风险 | 说明 |
|---|---|
| 客户集中 | 从阿联酋(2025 年 86%)转到 OpenAI(RPO 中约八成以上,推算);OpenAI 同时在用 NVIDIA、AMD、Broadcom 和自研 Jalapeño |
| 盈利 | GAAP 毛利率 14%、Q2 GAAP 亏损 4.5 亿美元;云业务重资产扩张(600 MW) |
| 容量与长上下文 | KV 受 SRAM 限制,Agent 长上下文负载下并发低(§3.3);要等 CS-6 |
| 竞争 | NVIDIA Groq 3 LPX 已量产,配合 Rubin;OLIX 2027 年进入 |
| 供应 | 台积电单一代工,按单采购;系统制造要扩 10 倍 |
| 落地验证 | GPT-6.1 Sol Ultrafast 平台存疑;750 MW 分批交付进度要看季度披露 |
待核实:
- WSE-3T 的实测功耗;
- CS-5 的工艺和规格;
- CS-6 的 DRAM 容量、带宽和键合方式;
- AWS 方案中 KV 传输的实际带宽;
- OpenAI 部署的实际 MW 数。
参考来源
本地:
ECOC 2026 with Claude/DAY2/Mo4-I-AI互连之争-第二场/0921-Mo4-待定-Cerebras-题目未公布.pdf(p4、p7、p9、p11–p16)
网络:
- Cerebras: Hot Chips 2026 deep dive
- ServeTheHome: WSE-3 Turbo and CS-4
- ServeTheHome: Cerebras rack scale at Hot Chips 2026
- Cerebras Q2 2026 results (SEC 8-K)
- Cerebras S-1 (April 2026)
- CNBC: Cerebras prices IPO
- CNBC: CBRS starts trading
- DCD: AWS partners with Cerebras for inference disaggregation
- Unite.AI: GPT-5.6 Sol at 750 tok/s on Cerebras
- OfficeChai: SemiAnalysis on GPT-6.1 Sol Ultrafast
- VentureBeat: Meta Llama API on Cerebras
- Cerebras: six new datacenters
- Mostly Metrics: S-1 breakdown(客户集中度)