本地原文:ECOC 2026 with Claude/ECOC2026_Insight_Report/OpenAI-Jalapeño推理芯片规格-深度分析-v1.md(v1.1)。厂商索引:AIDC 客户 · OpenAI
2026-10-06|v1.1 新增 §9:全局域 2,048 颗的 8 rail 组网推演|依据:ECOC 2026 现场 OpenAI 三份讲稿(本地)、Hot Chips 2026 公开披露、分析机构报道
来源标记:
- 【官方】OpenAI、Broadcom 发布或 Hot Chips 2026 讲稿;
- 【机构】SemiAnalysis、The Register、ServeTheHome 等第三方报道,可能含其自身推断;
- 【本地】ECOC 2026 现场讲稿;
- 【推算】本文根据上述数据计算,非披露值。
0. 一句话结论
Jalapeño 是一颗按”解码时延”设计的推理芯片。设计取舍可以概括为三点:
- 带宽重于算力: 同功耗下,HBM 带宽约为 GB300 的 3.9 倍,FLOP/Byte 只有 GB300 的一半左右。
- 本地内存重于全局共享: 64 个 core slice 各有一片 HBM,切片之间走专用 collective 网络。
- 以太网 scale-up 重于私有协议: 128 颗芯片用 TH6 单跳互联;2,048 颗分两级、走 8 个 rail。
三家的分工如下:
- OpenAI:架构、软件栈,以及 AI 辅助设计;
- Broadcom:芯片实现、SerDes/IO、HBM PHY、TH6 交换芯片;
- Celestica:板卡、托盘、机架、系统集成与量产。
1. 时间线
| 时间 | 事件 | 来源 |
|---|---|---|
| 2025-10 | OpenAI 与 Broadcom 签约,合作 10 GW 定制加速器及 Broadcom 网络,2026 下半年起部署 | 【官方】 |
| 2025-11 | 计算 die 流片(CoWoS 设计)。从 RTL 到流片约 9 个月 | 【机构】SemiAnalysis;“9 个月”为【官方】 |
| 2026-06-24 | 正式发布 Jalapeño,OpenAI 称之为”第一颗 Intelligence Processor”。工程样片已达到量产目标频率和功耗 | 【官方】 |
| 2026-08 | Hot Chips 2026 完整披露。A0 硅片运行于 1.70 GHz,目标 1.80 GHz;B0 stepping 在 fab 中,能效约 +25% | 【官方】+【机构】 |
| 2026-09-20 | ECOC 2026 上,OpenAI 两场讲 scale-up 系统与性能曲线,一场讲铜互连 | 【本地】 |
| 2026 年底 | 首批生产部署 | 【官方】 |
| 2027 | 逐步爬坡,大部分产出集中在 2027 年底 | 【机构】SemiAnalysis |
2. 芯片级规格总表
| 项目 | 数值 | 来源 / 置信度 |
|---|---|---|
| 定位 | LLM 推理专用;不做 PD 分离,prefill 与 decode 在同一套硬件上混跑 | 【官方】 |
| 工艺 | 计算 die:TSMC N3P;IO chiplet:N3E | 【机构】SemiAnalysis |
| 计算 die | 单颗、接近 reticle 极限(约 800 mm² 级);确切面积未披露 | 【官方】“reticle-sized”;面积为【推算】 |
| 封装 | CoWoS 类 2.5D:计算 die、IO chiplet 和 HBM4 同封装 | 【机构】 |
| 主频 | A0 为 1.70 GHz,目标 1.80 GHz | 【官方】 |
| MXFP4 稠密算力 | 13.4 PFLOPS | 【官方】 |
| MXFP8 算力 | 3.4 PFLOPS(为 FP4 的 1/4,而不是常见的 1/2,说明阵列明显偏向 FP4) | 【官方】;解读为【推算】 |
| 其他精度 | 64-bit 标量核,FP32/INT32 向量核 | 【机构】 |
| 计算组织 | 空间架构(spatial / NUMA 式):64 个 core slice,每个含 tensor(权重驻留脉动阵列)、SIMD 和标量引擎;乱序核加 L1 cache,不用软件管理的 scratchpad,以减少 barrier 等固定开销 | 【本地】A1 p6;【官方】;【机构】 |
| 片上 SRAM | ”大容量 SRAM”,用于把中间结果和部分 KV cache 留在片上;容量未披露 | 【机构】The Register |
| HBM | HBM4,216 GiB,约 6 堆 × 12-Hi × 36 GB;供应商为 Samsung | 容量为【官方】;堆叠为【机构】Register;供应商为【机构】SemiAnalysis |
| HBM 带宽 | 15.4 TB/s;pin 速率 10 Gb/s(Rubin 为 9.6 Gb/s) | 带宽为【官方】;pin 速率为【机构】 |
| 内存组织 | 每个 core slice 对应一片 HBM,有低时延的本地视图;slice 之间用专用的高带宽 collective 网络,另有通用 NoC | 【本地】A1 p6;【官方】 |
| TDP | 700 W | 【官方】 |
| 对外 IO | 32 条 200G SerDes(位于 N3E IO chiplet):24 条用于本地 scale-up(4.8 Tb/s,即 600 GB/s 单向),8 条用于全局 scale-up(1.6 Tb/s,即 200 GB/s) | 600/200 GB/s 为【官方】;lane 拆分为【机构】,并经【推算】自洽验证(见 §4.1) |
| Host 接口 | PCIe Gen5 连接 x86 主机(AMD EPYC Turin) | 【机构】 |
| scale-up 协议 | 以太网(scale-up Ethernet bridge 在芯片上),不是 NVLink 或 UALink 私有链路 | 【本地】A1 p6–p7 |
2.1 自洽性检查【推算】
HBM 带宽:
- HBM4 为 2048-bit 接口,10 Gb/s × 2048 ÷ 8 ≈ 2.56 TB/s 每堆;
- × 6 堆 = 15.4 TB/s,与官方值完全吻合。
- 因此”6 堆 HBM4 @10 Gb/s”基本可以确认。
HBM 与 slice 的对应:
- HBM4 每堆 32 个通道,6 堆共 192 个通道;
- 192 ÷ 64 slice = 3 通道 / slice;
- 每个 slice 约 3.4 GB 容量、约 240 GB/s 带宽。
- 这和”每个 slice 一片 HBM”的描述吻合。
每 slice 算力:
- 13.4 PF ÷ 64 ÷ 1.7 GHz ÷ 2 ≈ 6.2 万 FP4 MAC/周期;
- 量级相当于每个 slice 有 3–4 个 128×128 的 FP4 阵列。
3. 与主流加速器的对比
数据口径: 单芯片公开规格,取近似值。NVIDIA 的 FP4 为稠密值;Rubin 的 50 PF 为 NVIDIA 公布的推理 NVFP4 口径,训练口径约 35 PF。
| 指标 | Jalapeño | GB200(B200) | GB300(B300) | Vera Rubin | TPU v7 Ironwood |
|---|---|---|---|---|---|
| 工艺 | N3P | N4P | N4P | N3P | N3 级 |
| FP4 PFLOPS | 13.4 | 10 | 15 | 50(35) | —(FP8 4.6) |
| HBM | 216 GB HBM4 | 186 GB HBM3E | 288 GB HBM3E | 288 GB HBM4 | 192 GB HBM3E |
| HBM 带宽(TB/s) | 15.4 | 8 | 8 | 22 | 7.4 |
| TDP(kW) | 0.70 | 1.2 | 1.4 | 约 1.8 | 约 1 |
| scale-up 单向带宽 | 600 GB/s 本地 + 200 GB/s 全局 | 900 GB/s | 900 GB/s | 1.8 TB/s | ICI |
| scale-up 域 | 128(一跳)/ 2,048(两级) | 72 | 72 | 72(144 die) | 9,216(3D torus + OCS) |
3.1 归一化后的设计倾向【推算】
| 每千瓦(芯片 TDP) | Jalapeño | GB300 | Rubin | 解读 |
|---|---|---|---|---|
| FP4 PF / kW | 19.1 | 10.7 | 约 27.8(19.4) | 算力 / W 介于 Blackwell 与 Rubin 之间 |
| HBM TB/s / kW | 22.0 | 5.7 | 12.2 | 核心差异: 带宽 / W 是 GB300 的 3.9 倍、Rubin 的 1.8 倍 |
| HBM GB / kW | 309 | 206 | 160 | 每瓦可放更多 KV cache |
| FLOP / Byte | 870 | 1,875 | 2,270(1,590) | 越低越适合 decode(带宽受限) |
结论: Jalapeño 不追峰值算力,而是用 700 W 换来接近 Rubin 一级的 HBM4 带宽。
LLM decode 每生成一个 token,都要把激活参数和 KV 从 HBM 读一遍,所以 FLOP/Byte 在 1,000 以下的芯片更”吃得饱”。这和它在高交互区(每用户 tokens/s 高、batch 小)大幅领先 GB300 的曲线相互印证(§5)。
4. 系统级:从托盘到 2,048 颗 pod
4.1 机架构成
| 层级 | 构成 | 来源 |
|---|---|---|
| ASIC 托盘(“Vindaloo”) | 8 颗 Jalapeño / 托盘 | 【本地】Su1-B-02 p7(16 托盘 × 8);【机构】 |
| ASIC 机架 | 16 个 Vindaloo + 8 个交换托盘(“Chana”:6 个本地、2 个全局),共 128 颗 | 【机构】SemiAnalysis;128 为【官方】 |
| 背板 | 机架内无源铜缆背板(类似 NVIDIA Oberon),约 6,144 对差分线 | 【本地】Su1-B-02 p7;【机构】 |
| Host 机架(“Katsu”) | 16 个 host 托盘,每托盘 2 颗 AMD EPYC Turin 与 1.5 TB DRAM;前端网络 2×200G;以 8 根外部 PCIe DAC 连接 ASIC 机架 | 【机构】 |
| 功耗 | ASIC 机架约 130 kW;host 机架按 50 kW 配置、实际约 31 kW;合计约 160 kW,相当于”双宽 GB300 机架” | 【机构】 |
| 冷却 | 130 kW 机架只能用液冷,官方未明说 | 【推算】 |
本地域连接自洽验证【推算】:
- 128 颗 × 24 条本地 lane = 3,072 条 200G lane;
- 6 颗 TH6 × 512 条 200G 端口 = 3,072 条,完全相等;
- 即每颗 Jalapeño 向 6 颗 TH6 各出 4 条 lane(每个平面 800 Gb/s),构成单跳、无收敛的 6 平面全互联;
- 3,072 条 lane × 收发 2 对 = 6,144 对差分线,与 SemiAnalysis 的”6,144 DPs”一致。
功耗拆分【推算】:
- 芯片 128 × 0.7 kW = 89.6 kW,约占 ASIC 机架的 69%;
- 其余约 40 kW 为 10 颗 TH6、HBM 外的板级器件、电源损耗和风扇泵等;
- 含 host 后约 1.26 kW / 颗;GB300 NVL72 约 1.9 kW / GPU(Grace 已计入)。
4.2 两级”半扁平”scale-up
本地域(单机架 128 颗):
- 每颗 600 GB/s;一跳 TH6;
- 张量并行放在这一级。
- SemiAnalysis 称从 TP8 扩到整机架 TP32 仅用 8 天。
全局域(16 机架 2,048 颗):
- 每颗 200 GB/s;8 个 rail(rail 0…7,对应每颗芯片的 8 条全局 lane);
- 跳数为两级 Clos;
- 专家并行、跨机架的 KV 传递和 DP 放在这一级。【本地】A1 p7;【官方】
全局级拓扑重建【推算】(v1.1 修订,依据 ECOC A1 p7 拓扑图;完整推演见 §9):
图上的两级交换分别是本地 TH6(上)和 rail TH6(下),Jalapeño 夹在中间、双归属。这就是”半扁平”的含义:
- 标准两级 Clos 是”节点 → leaf → spine”;
- 这里节点同时直连两级交换,省掉 leaf↔spine 这一层链路。
rail 映射(按 16 托盘 × 8 推断):
- 托盘第 k 个槽位的芯片接 rail k;
- 每个 rail 有 16 机架 × 16 托盘 = 256 颗;
- 每颗把 8 条全局 lane 拆成 4 × 2 条,分别接本 rail 的 4 颗 TH6;
- 每颗 TH6 = 256 颗 × 2 条 = 512 端口,正好用满。
全局 TH6 数量:
- 8 rail × 4 = 32 颗(16,384 个 200G 端口);
- 合每机架 2 颗,对应 2 个全局交换托盘各 1 颗;
- SemiAnalysis 说”每托盘 2 颗(potentially)“,若属实则为 64 颗,但端口会有一半空闲或用于 rail 内互联。
整个 pod: 本地 96 + 全局 32 = 128 颗 TH6,每颗 Jalapeño 占 32 个 200G 交换端口。
跨机架链路:
- 每机架 1,024 条全局 lane 中,约 1/16 落在本机架的 rail TH6 上;
- 实际跨机架约 960 条 × 200G;整个 pod 约 15,360 条(约 3.07 Pb/s);
- 若全部用 800G 光:约 3,840 条链路,7,680 只模块,每颗约 3.75 只 800G;
- SemiAnalysis 提到”铜背板与光配线(patch panel)混合”,实际光 / 铜比例未披露。
4.3 2,048 颗 pod 的总量
| 项目 | 数值 | 来源 |
|---|---|---|
| MXFP4 | 27 EFLOPS | 【官方】 |
| HBM 容量 | 432 TiB | 【官方】 |
| HBM 带宽 | 32 PB/s | 【官方】 |
| 功耗(含 host) | 约 2.6 MW | 【推算】160 kW × 16 |
5. 性能:厂商自报数据汇总
| 对比 | 模型 | 结果 | 来源 |
|---|---|---|---|
| 对 GB200(1.2 kW) | GPT-OSS-120B | 峰值混合 tokens/s/kW 为 1.9×;端到端时延低 1.7×;最高吞吐点约为 GB200 的 2 倍;并发为 1 时约 50× | 【官方】Hot Chips;【机构】 |
| 对 GB300(1.4 kW) | DeepSeek-R1 | 峰值效率 1.7×;端到端时延低 3.6× | 【官方】Hot Chips |
| 对 GB300 MTP | ECOC 现场曲线 | 最小请求时延 1.65 s 对 3.69 s(约 2.2×);同为约 10,500 tokens/s/kW 时时延低约 1.8×;约 200 tok/s/user 时效率约 9,000 对 1,500(约 6×);GB300 MTP 在约 330 tok/s/user 时达到上限,Jalapeño 可达约 700 | 【本地】A1 p8(读图) |
| 对所有对手 | Kimi K2.5 | 约 700 tok/s/user;在 100 tok/s/user 时为次优芯片的 9 倍以上 | 【机构】SemiAnalysis(数据由 OpenAI 提供) |
| 对 Vera Rubin | TCO | 每美元输出 token 数”基本持平” | 【机构】SemiAnalysis |
| 成本 | — | 每推理 token 成本约为 NVIDIA GPU 的 50% | 【机构 / 媒体】,未经独立验证 |
注意事项:
- 所有数据均由 OpenAI 提供,尚无独立第三方实测。SemiAnalysis 特别说明,其偏好的长上下文基准 AgentX 还没有 Jalapeño 的结果。
- 关于推测解码,各方说法不一致:
- STH 记录 Hot Chips 讲稿中有”8 个输出 token / 1 次大模型前向”的推测解码;
- SemiAnalysis 称部分图表中 Jalapeño 未用 MTP,而对手用了 MTP;
- 可能是不同图表口径不同,需对照原始讲稿。
- 对比对象是 Blackwell 一代;与同为 HBM4 的 Rubin 相比,TCO 大致相当,优势不再是数量级。
5.1 为什么 700 tok/s/user 可行,以及互连为什么关键【推算】
以 Kimi K2.5 类 MoE 为例:约 1T 总参数,约 32B 激活参数,61 层。
带宽侧:
- 每 token 读激活权重:FP4 约 16 GB;
- TP32 下聚合 HBM 带宽 32 × 15.4 ≈ 490 TB/s;
- 仅读权重的上限约 3 万 tok/s,带宽不是瓶颈。
通信侧:
- 700 tok/s/user,意味着每 token 约 1.4 ms;
- 61 层 × 每层约 2 次集合通信(TP all-reduce 与 EP all-to-all)≈ 120 次;
- 每次集合通信的预算约 10 µs 量级,其中还要扣掉计算。
含义:
- 在高交互区,时延主要由 scale-up 网络的跳数、SerDes / FEC 时延和抖动决定。
- 这正是 OpenAI 在 ECOC 上反复强调”按时延和可靠性选互连”的原因:本地单跳 TH6 是 Jalapeño 曲线能够延伸到约 700 tok/s/user 的前提。
5.2 容量侧:适合 Agent 长上下文【推算】
- 单机架 HBM: 128 × 216 GB ≈ 27.6 TB。
- 权重: 1T 参数 FP4 加缩放因子约 0.55 TB,只占约 2%。
- KV cache: MLA 类 KV 约 70 KB/token,余量约可容纳 3.8 亿 token。
- 折合: 约 3,000 个 128K 上下文的并发会话。
- 含义: “不做 PD 分离、prefill 与 decode 混跑”有容量基础。这也呼应了多 Agent 场景对 KV 命中率 ≥95% 的需求(见 AI 数据中心布局与训练推理流量调度)。
6. 三方分工
| 角色 | 具体内容 | 来源 |
|---|---|---|
| OpenAI | 架构定义(spatial / NUMA、slice-HBM 本地化、collective 网络);用 XLS HDL 写 RTL;AI 辅助设计(内部模型与 Codex,SIMD 面积 −8%、矩阵引擎面积 −10%);性能模拟器 chilisim(误差 <5%);内核语言 Gluon(基于 Triton,以 linear layout 为核心抽象);推理引擎 Teacup;在硅片上 3 个月完成模型 bring-up | 【官方】+【机构】 |
| Broadcom | 物理实现与后端;N3E IO chiplet(200G SerDes、HBM4 PHY);CoWoS 封装协调;TH6 交换芯片;10 GW 框架下的网络(scale-up 与 scale-out) | 【官方】+【机构】 |
| Celestica | 板级、机架级与系统集成: ASIC 托盘、交换托盘、host 机架、铜背板、供电与液冷集成;高性能网络(交换托盘基于 TH6);可量产的生产体系(ODM/EMS 制造与测试);SemiAnalysis 原话为”系统级设计与 Celestica 合作完成” | 【官方】发布稿;【机构】 |
为什么是 Celestica(背景判断):
- 它长期是 Broadcom Tomahawk 系列白盒交换机(如 TH5/TH6 参考设计)的主要 ODM,也是北美超大规模厂商 AI 机架和交换机的核心代工方。
- TH6 交换托盘、铜背板机架和大功率液冷这三件事,都在它的现有能力圈内。
- 有媒体称 Jalapeño 机架”直接部署到 Microsoft Azure 数据中心”,来源质量较低,未能证实。
7. 对光互连的启示
1. 当前一代:机架内全铜,光只在跨机架一级。
- 本地 3,072 条 200G lane 全部为无源铜背板。【本地】Su1-B-02:200G/lane 铜缆约 1 m 可达。
- 光的机会在全局一级:按 §4.2 的上限估算,约每颗 3.75 只 800G,每 pod 约 7,680 只。
2. 下一代:400G/lane 时铜会撞墙。
- Su1-B-02 指出,400G/lane 时铜缆可达仅约 1 m,且需要更强 FEC,带来时延。
- 若下一代 Jalapeño 把本地 lane 升到 400G,或把本地域扩到多机架,机架内也会转向 OCI / NPO / XPO。OpenAI 在 A1 讲稿给出的选型顺序是:时延 → 可靠性(FIT)→ 功耗 → 成本。
3. 规模量级【推算,上限情景】:
- 10 GW ÷(约 1.26 kW / 颗 × PUE 1.2)≈ 660 万颗(假设全为 Jalapeño 这一代;实际为多代混合);
- 每 GW 约 66 万颗,约 320 个 pod;
- 若跨机架全光,约 250 万只 800G 等效模块 / GW。
- 这是 OpenAI 自研路线给以太网 scale-up 光学带来的增量市场上限,实际取决于跨机架的铜 / 光比例。
4. 以太网 scale-up 得到实证。
- Jalapeño 是继 Google TPU(ICI 加 OCS)之后,又一个不用 NVLink 的大规模 scale-up 系统,而且直接基于商用 TH6。
- 这对 ESUN、SUE、OCI-MSA 等开放以太网 scale-up 生态是一次强背书。
8. 未披露或待核实
- 计算 die 的确切面积、SRAM 容量、core 微架构细节(阵列尺寸、向量宽度);
- HBM4 的堆数与堆高(6 × 12-Hi 为 Register 的推断);封装形式(CoWoS-L 还是 CoWoS-R);
- 冷却方式、单机架重量,以及 host 与 ASIC 机架的物理布置;
- 全局一级的实际光 / 铜比例,以及是否使用 OCS(SemiAnalysis 提到 optical patch panel);
- 推测解码的口径不一致,见 §5 注意事项第 2 条;
- 单价、良率与 2027 年出货量(SemiAnalysis 付费内容);
- 下一代(multi-generation platform)的路线。
9. 全局域 2,048 颗:两层组网与 8 rail 推演【推算】
官方只给出三条: 128 / 2,048 颗;“半扁平”两级 Clos;全局 8 个 rail,每颗 200 GB/s。 接线方式和 TH6 用量都是本节根据 ECOC A1 p7 拓扑图(即 Hot Chips 2026 讲稿第 6 页)推演的结果。
9.1 拓扑图读法
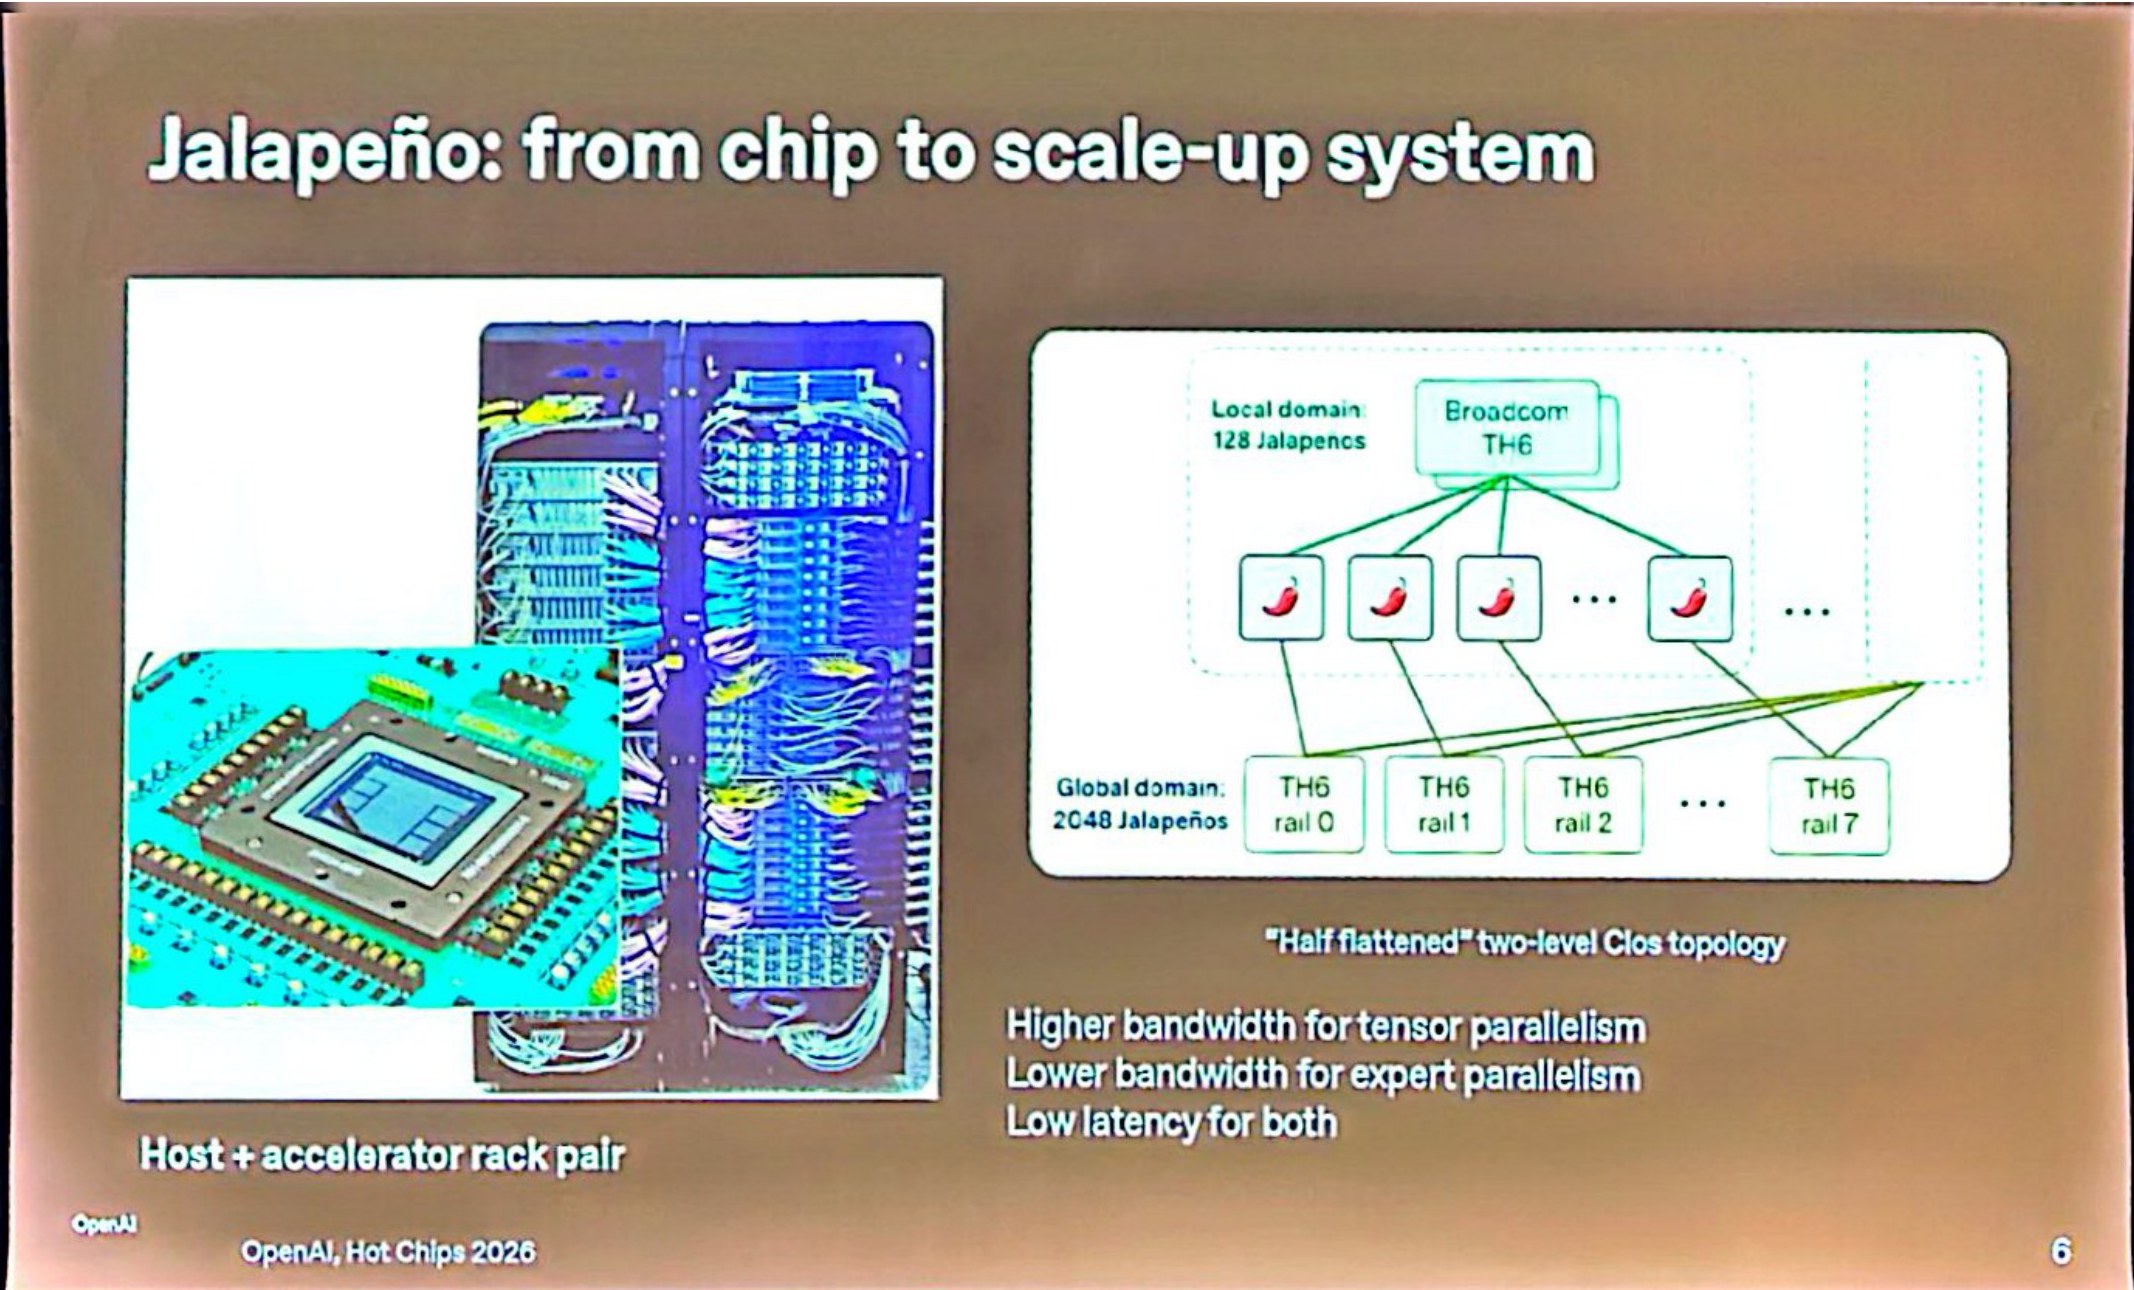
来源:ECOC 2026 现场|OpenAI 0920-pm-Su3-A-02 p7(即 Hot Chips 2026 讲稿第 6 页)
A1 p7 右图从上到下分三层:
- 上层: “Local domain: 128 Jalapeños”,接 Broadcom TH6(画成叠放的多颗);
- 中层: Jalapeño 芯片,图上画为辣椒图标;
- 下层: “Global domain: 2048 Jalapeños”,接 TH6 rail 0、rail 1 …… rail 7。
连线方式:
- 本机架各芯片分别连到不同 rail;
- 右侧虚线框代表其他本地域,它们的连线也汇入同一组 rail。
图注:
- “Half flattened” two-level Clos topology;
- Higher bandwidth for tensor parallelism / Lower bandwidth for expert parallelism / Low latency for both。
9.2 两层怎么组:芯片同时直连两层交换
            [本地 TH6 ×6]      ← 每颗 24×200G(600 GB/s),机架内一跳
                  │
     Jalapeño ×128 / 机架      …… ×16 机架
                  │
   [rail0][rail1] … [rail7]    ← 每颗 8×200G(200 GB/s),跨机架一跳
为什么叫”半扁平”:
- 标准两级 Clos 是”节点 → leaf → spine”,所有跨 leaf 流量都走 leaf↔spine 链路。
- 这里两级交换都直接接芯片:本地 TH6 相当于 leaf,rail TH6 相当于 spine。
- 芯片本身充当 leaf 的上行口,省掉了 leaf↔spine 这一层链路。
路由:
| 通信对 | 路径 | 交换跳数 |
|---|---|---|
| 同机架 | 本地 TH6 | 1 |
| 跨机架、同 rail | rail TH6 | 1 |
| 跨机架、不同 rail | 本地 TH6 → 本机架接目标 rail 的芯片中转 → rail TH6;或反向 | 2,中间经过一颗芯片转发(类似 NCCL PXN) |
与并行方式对应:
- 张量并行放在机架内,一跳、600 GB/s;
- 专家并行的 all-to-all 分两段:先在机架内重排(带宽充足),再走 rail 跨机架;
- 任意两颗芯片之间最多两跳交换。
- 机架内带宽是全局的 3 倍,所以中转一跳的代价不大。
9.3 8 个 rail 怎么组
主方案:托盘槽位映射 rail,与”16 托盘 × 8”吻合
- 每个托盘第 k 个槽位的芯片接 rail k(k = 0…7),类似英伟达”服务器内第 k 张 GPU 接 rail k”的做法。
- 每个 rail 的芯片数 = 16 机架 × 16 托盘 = 256 颗;带宽 256 × 1.6 Tb/s = 409.6 Tb/s,需要 4 颗 TH6。
- 每颗芯片把 8 条全局 lane 拆成 4 组 × 2 条,分别接本 rail 的 4 颗 TH6,形成 4 个平面。
- 同 rail 任意两颗芯片在 4 个平面上都一跳可达,合计 1.6 Tb/s。
- 每颗 rail TH6:256 颗 × 2 条 = 512 个 200G 端口,正好满配。
两种不成立的接法:
- 每颗用一个 1.6T 端口整口接一颗 TH6: 每颗 TH6 只能接 64 颗,rail 会被切成 4 个互不相通的 64 颗小组。
- 第 k 条 lane 接 rail k(每颗都上全部 8 个 rail): 每个 rail 要 2,048 个端口,单颗 TH6 放不下,同样被切成互不相通的小组。可能性较低。
9.4 TH6 用量
| 层级 | TH6 数量 | 200G 端口 | 校验 |
|---|---|---|---|
| 本地层 | 6 / 机架 × 16 = 96 | 49,152 | 128 × 24 = 3,072 = 6 × 512 |
| 全局 rail 层 | 8 rail × 4 = 32(约每机架 2 颗) | 16,384 | 2,048 × 8 = 16,384 = 32 × 512 |
| 合计 | 128 | 65,536 | 每颗 Jalapeño 占 32 个交换端口 |
与 SemiAnalysis 的出入:
- SemiAnalysis 写的是每机架 2 个全局交换托盘、每托盘”potentially”2 颗 TH6,合 64 颗,是本推演的 2 倍。可能的解释有三种:
- 每托盘实际只有 1 颗,正好对上 32 颗;
- 多出的一半端口用于同一 rail 内交换机之间的互联,也就是在 rail 内部再做一层扁平互联;
- 冗余或预留端口。
- 本地层的 6 颗 / 机架与 SemiAnalysis 的”6 个本地交换托盘”一致。
与标准 Clos 的对比:
- 用无阻塞两层 Clos 连接 16,384 个端口,需要 64 颗 leaf(256 下 / 256 上)加 32 颗 spine,共 96 颗,任意两颗芯片都是 2 跳。
- 半扁平方案全局层只用 32 颗,交换芯片和跨机架光链路都省掉约 2/3。
- 代价是跨 rail 通信要经过一颗芯片中转。
9.5 跨机架链路与光模块
| 项目 | 数值 |
|---|---|
| 每机架全局 lane | 1,024 条 × 200G |
| 落在本机架 rail TH6 上的比例 | 约 1/16 |
| 每机架跨机架 lane | 约 960 条 |
| 每 pod 跨机架 lane | 约 15,360 条(约 3.07 Pb/s) |
| 若全部用 800G(4×200G)光 | 约 3,840 条链路、7,680 只模块,每颗约 3.75 只 |
| 若用 1.6T(8×200G)光 | 约 1,920 条链路、3,840 只模块;但每颗芯片要拆成 4 组 × 2 条接到 4 颗 TH6,需要 1.6T→4×400G 分支 |
- SemiAnalysis 提到跨机架为铜背板与光配线(patch panel)混合,实际光 / 铜比例未披露。
- rail TH6 若集中放在网络机架,而不是分散在 16 个机架里,以上链路数量基本不变。
9.6 置信度
| 内容 | 级别 |
|---|---|
| 128 / 2,048、8 rail、TH6、“半扁平”两级 Clos、600 / 200 GB/s | 【官方】 |
| 16 托盘 × 8、6 个本地交换托盘 + 2 个全局交换托盘 | 【本地】+【机构】 |
| 槽位对应 rail、4 组 × 2 条接法、32 颗全局 TH6、芯片中转路由、光模块数量 | 【推算】,待 OpenAI 后续披露或 Hot Chips 原始讲稿核实 |
参考来源
本地(ECOC 2026,DAY1 9-20):
- A1-Su3-Su4/0920-pm-Su3-A-02-OpenAI-ScaleUp互连需求.pdf:p6 芯片、p7 系统、p8 性能曲线;
- PV-R-Su3-Su4/0920-pm-Su4-I-02-OpenAI-ScaleUp需求.pdf:p5–p6;
- A2-Su1-Su2/0920-am-Su1-B-02-OpenAI-ScaleUp还能用铜吗.pdf:p6–p7,铜背板、16×8、TH6。
网络:
- ServeTheHome: OpenAI Jalapeño at Hot Chips 2026
- SemiAnalysis: OpenAI Jalapeño – Better Than Nvidia Blackwell
- The Register: Jalapeño looks like an inference beast
- Tom’s Hardware: Hot Chips 2026 Jalapeño unpacked
- Tom’s Hardware: Broadcom and OpenAI unveil Jalapeño
- TechCrunch: OpenAI unveils its first custom chip
- All About Circuits: Meet Jalapeño
- Techzine: OpenAI and Broadcom unveil Jalapeño