版本 v1 · 2026-10-06
原文信息
| 项 | 内容 |
|---|---|
| 原文 | SemiAnalysis 长文,作者为架构师 Tanj Bennett |
| 中文译文 | 微信公众号”6点关机”,《SemiAnalysis 重磅长文:前沿 MoE 大模型推理、数据搬运与硬件架构终极拆解》,2026-10-02 |
| 链接 | https://mp.weixin.qq.com/s/kQ3Nw2_C8zGOpLaJ13Rr8Q |
| 篇幅 | 约 4.3 万字,23 节,29 张图(另有 1 张封面插画) |
| 性质 | 前半篇是概念框架(四阶段、层组、逻辑节点、并行边界);后半篇用 SemiAnalysis 自有推理模拟器,把 Kimi K3 映射到 B200、B300 和 GB200 NVL72 上做推演。模拟结果不是实测数据。 |
阅读提醒:
- 中文译文措辞很夸张,例如”毁天灭地""轰杀成渣”。本文只提取技术判断和数字,不沿用这些修辞。
- 文中的”约""读图”表示数值是从图上读出来的。
一、一句话结论
文章把推理服务看成一座 “Token 工厂”,核心观点可以归为三句话:
- 按阶段拆: 推理应拆成 Prefill、Midfill、Decode Attention、Decode Experts 四个阶段,各自配硬件、并行方式和批策略。
- 按数据流放网络边界: 高频、对时延敏感的专家 all-to-all 和 TP 规约必须锁在 scale-up 域内。层间激活值很小,KV blob 虽然大但只在阶段切换时搬一次,这两类都交给 scale-out 网络和共享存储。
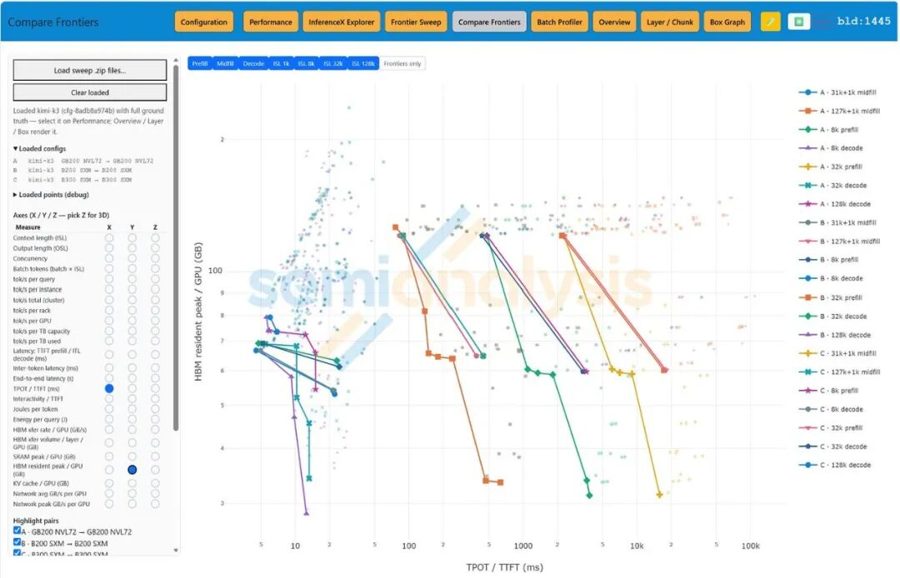
- 单卡显存不必很大: 带宽、网络边界放置和调度比单卡显存容量更重要。模拟里,帕累托前沿上大多数配置的单卡峰值 HBM 驻留都低于 80 GB。
二、核心论点
1. 四个阶段与”Token 工厂”(§0–3、§6)
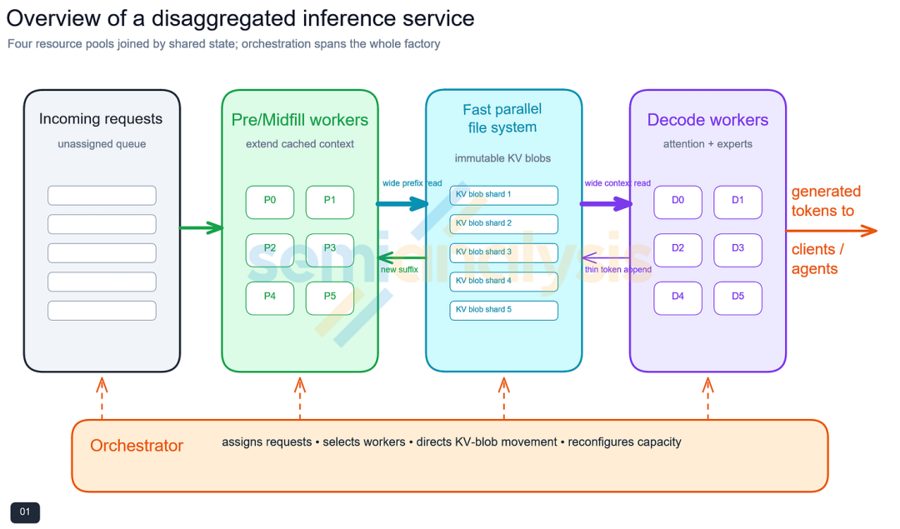
典型流转: 请求进入队列 → Pre/Midfill Worker 扩展上下文 → KV 以不可变 blob 写入并行文件系统 → Decode Worker 读取并生成 → 工具、Agent 返回结果后,再回到 Midfill。编排层(Dynamo、Mooncake 等)调度全程。
| 阶段 | 输入特征 | 瓶颈 | 批处理收益 |
|---|---|---|---|
| Prefill | 大块新 token,几乎没有缓存;冷启动很少超过 10 万 token | 算力 | 高:按专家排序后,每个专家只加载一次 |
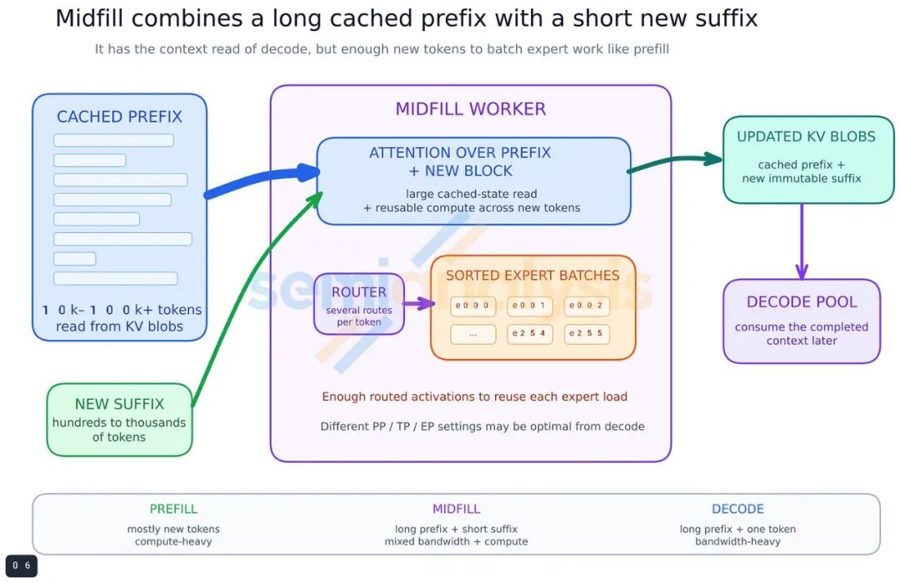
| Midfill(本文提出的独立阶段) | 长缓存前缀(10k–100k+,可到 50 万)+ 短后缀(50–5,000 token) | 带宽和算力都吃:既要读数十 GB 的 KV,又能做专家成批计算 | 中高:算术强度比 Decode 高上百倍 |
| Decode Attention | 每次 1 个或几个 token(MTP) | HBM 带宽(扫描私有 KV) | 很低:每个请求的 KV 都是私有的 |
| Decode Experts | 每个 token 从几百个专家里选 8–16 个 | HBM 带宽(加载专家权重) | 低:小 batch 时专家很少被多个请求共享 |
Midfill 为什么要单独设池:
- 它的最优 PP、TP、EP 配置和 Decode 不同。
- 它是突发负载,会拖慢同一流水线上的 Decode。
- 硬件可以和 Decode 池完全相同,只是加载的模型切片、并行度和批策略不同。
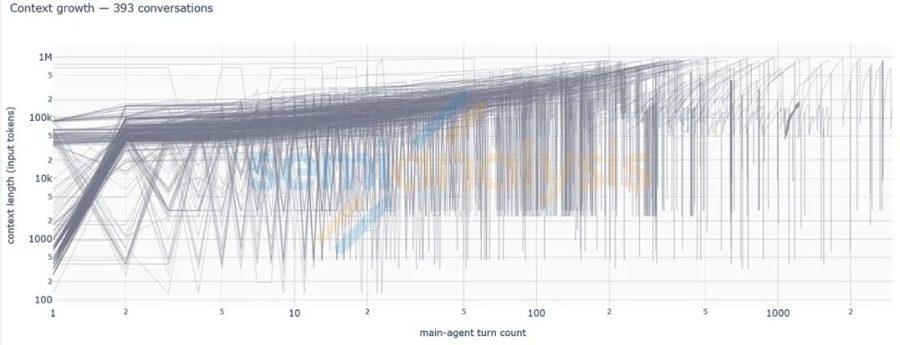
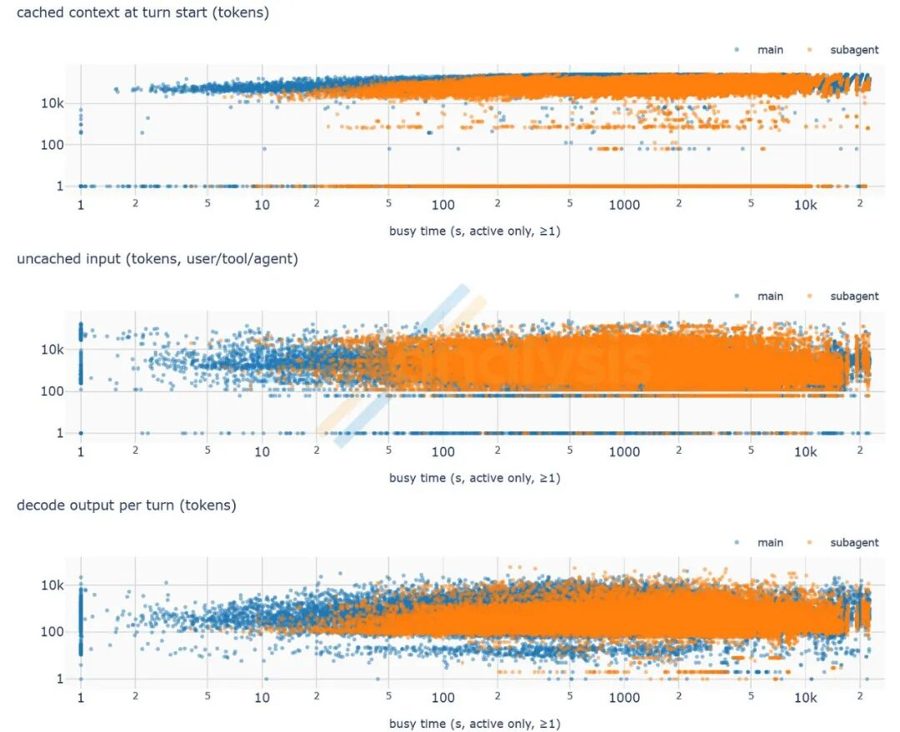
Agent 负载特征(AgentX 第 34 版,“CC Traces Weka”数据集,393 段对话):
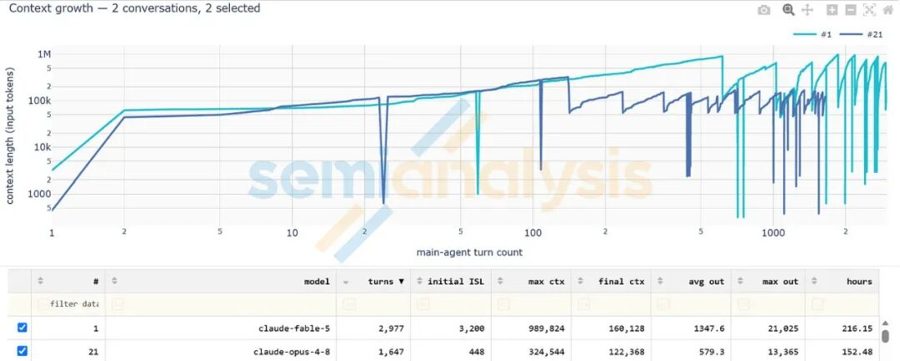
- 上下文增长很快,在接近上限时会被压缩(compaction),曲线呈台阶状下降,还有短暂的骤降。
- 原文给出的实用上下文上限:Opus 4.8 约 250k,Fable 约 1M。
- 图 4 中的两段长对话:
| 模型 | 轮次 | 最大上下文 | 持续时间 |
|---|---|---|---|
| claude-fable-5 | 2,977 | 989,824 | 216 小时 |
| claude-opus-4-8 | 1,647 | 324,544 | 152 小时 |
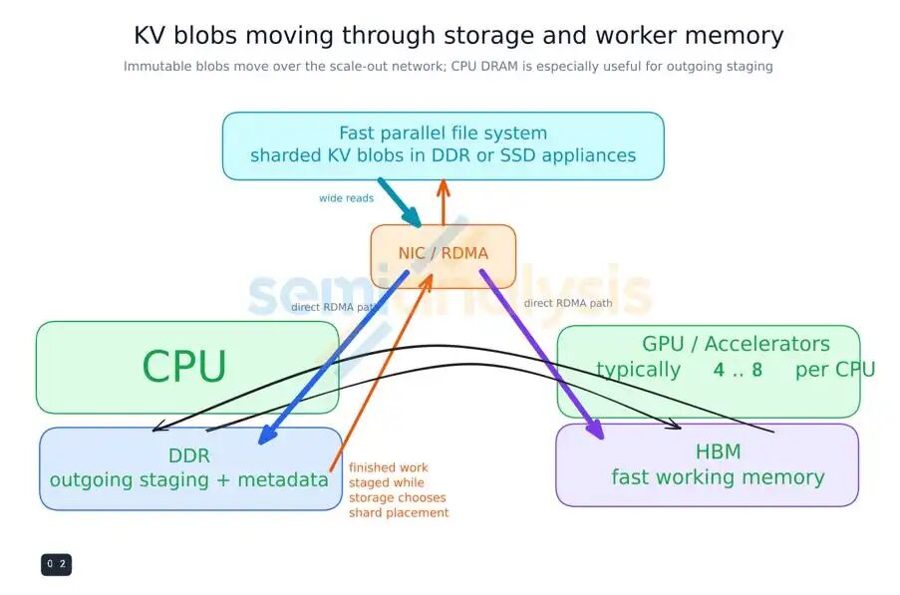
2. KV 作为不可变 blob(§2)
- 只追加: 系统提示、项目上下文、历史轮次、工具结果和生成 token 各自封装成 blob,只追加不覆写。对话分支时回溯后另开新分支。
- 分层存放:
- HBM 只放正在计算的数据,算完立即迁出;
- CPU DRAM 是输出暂存层;
- 输入走 GPUDirect RDMA,直接写入显存;
- 再往下是并行文件系统(DDR 或 SSD 设备);
- 系统提示这类热门对象适合放在机架级缓存。
- 可以用重算换空间: 原始文本比展开后的 KV 小几个数量级,必要时可以从文本重算 KV。
- 读多写少: 读取远多于写入,带宽配比应该反映这种非对称。
- 跨节点搬运: 数 GB 的 KV 可以条带化或用类似 BT 的并发方式传输,耗时小于 1 秒,远低于一次长 Decode 的时长。
- 参考文献: 原文推荐 LMSYS 的《Unified Radix Cache》。
3. 并行边界:沿数据流最窄处切(§7–13)
三种并行各切什么:
- PP 切层: 层间激活值很小,可以跨弱链路。代价是流水线里同时有多个批次,每个 stage 都要持有各批次的 KV。
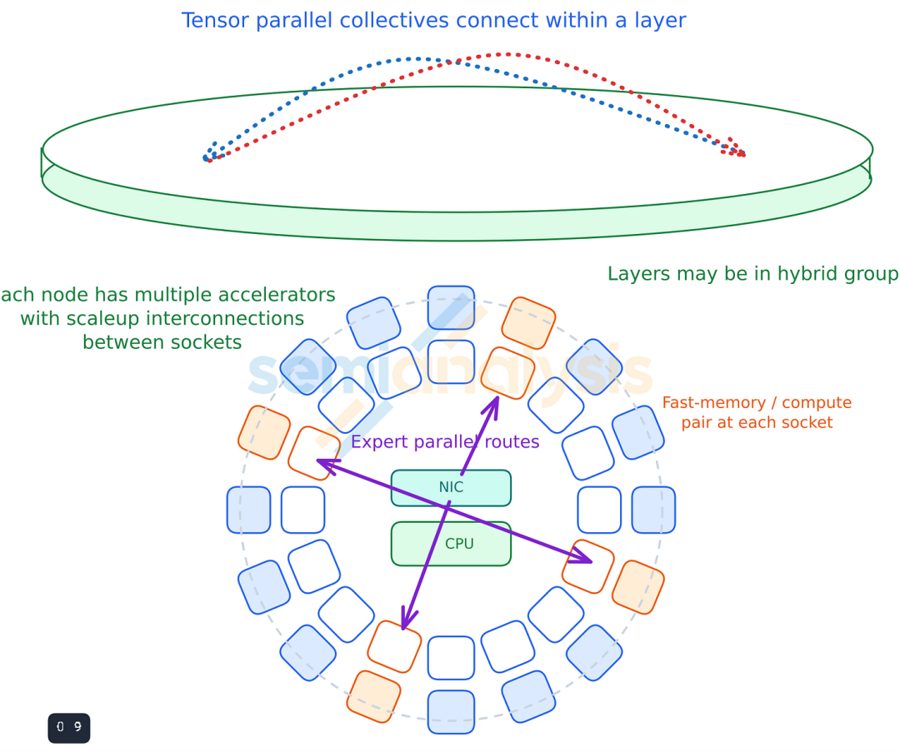
- TP 切不可分的宽操作: 主要是长上下文注意力和大的稠密线性层。不要把 TP 用到小的专家张量上,否则集合通信时间会超过计算时间。
- EP 切专家: 专家没有上下文,可以铺得很宽,交换机端口数和本地显存可以分开规划。
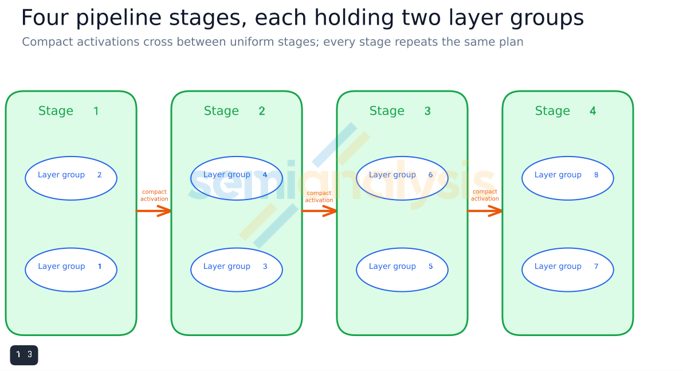
切分单位: PP 尽量按层组切。层组通常是 1 个全注意力层加若干线性或局部注意力层,最底下 1–3 层可能是稠密层。
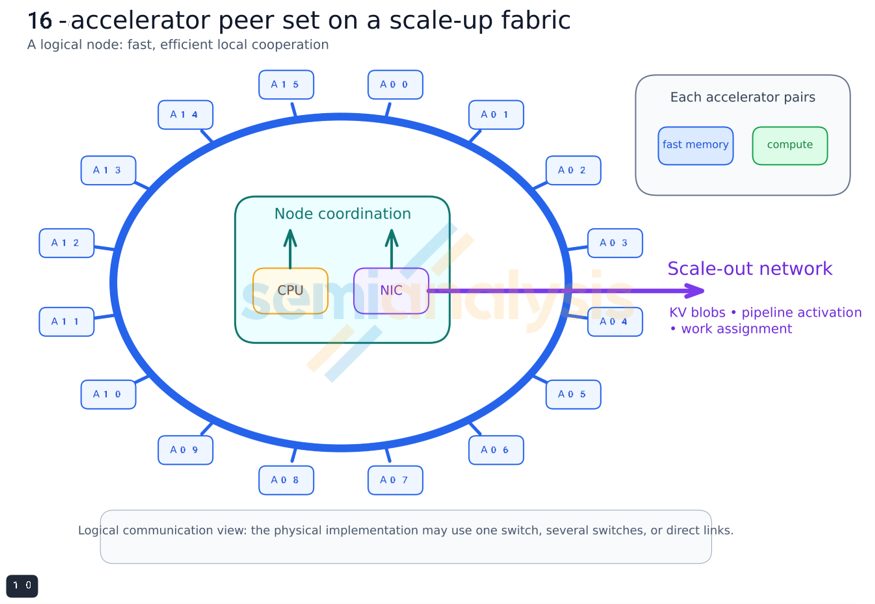
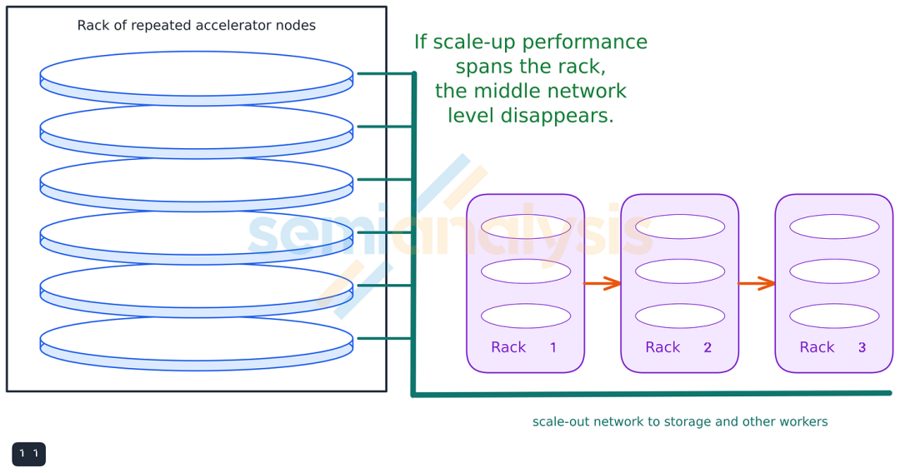
逻辑节点: 约 16 颗加速器组成一个对等组,物理拓扑不限(交换、全互联、torus 等)。scale-up 覆盖整个机架时(如 NVL72),机架内的中间网络层就不存在了。
时延敏感度:
- 一次专家计算只要几微秒,所以每一跳多 100 ns 都会明显影响帧率。
- 跨层组的流水线搬运多几微秒则无关紧要。
每层时间预算:
- 单层 50 µs–1 ms,60 层模型对应每秒 15–300 token;
- 子步骤要在微秒到亚微秒内完成;
- 0.2 µs 的专家 GEMM,如果前后各有 3 µs 的分发开销,就没有意义了。
4. KV 交叉点公式(§14)
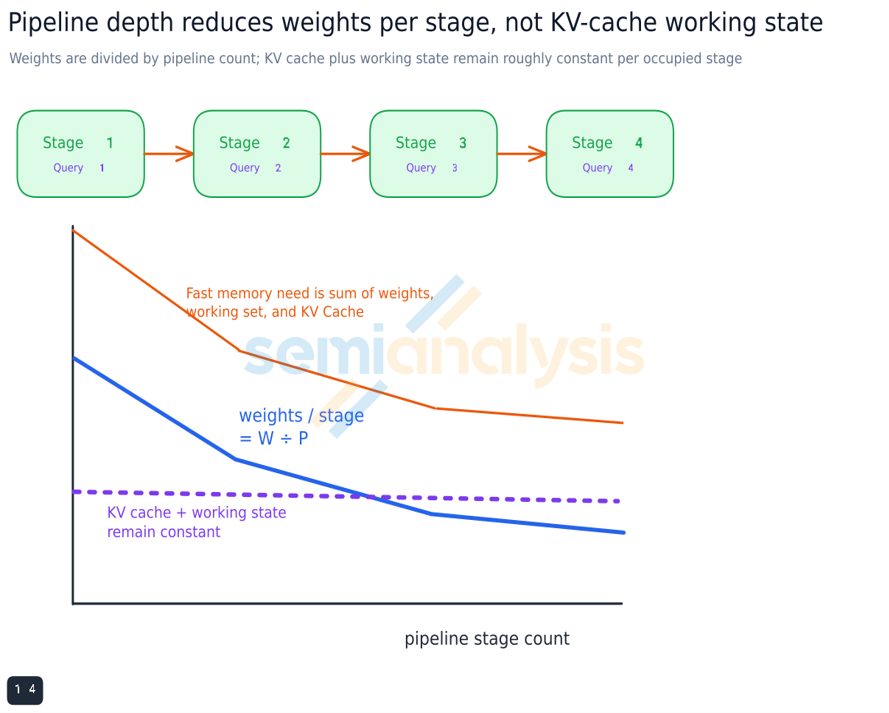
单 stage 显存需求:
- 权重随 PP 深度 P 线性下降。
- KV 加工作集基本不随 P 变化:层数变少,但同时在飞的批次变多,两者抵消。
- 当 W/P 降到与 KV 同一量级时,再加深流水线几乎省不了显存,只会增加时延(图 19)。
每 token KV 大小基线:
| 注意力类型 | 每 token KV |
|---|---|
| 全注意力 | 数百 KB |
| MLA 等成熟压缩注意力 | 约 70 kB |
| 新型混合层组 | 约 25 kB |
算例:
- 70 kB × 200 万活跃 token = 140 GB;双缓冲后为 280 GB;
- 加上权重、激活、通信缓冲、路由表、碎片和裕量,每个 stage 约需 400–500 GB 高速内存;
- 原文把这作为 2027 年前沿系统的基准配置,可以由多颗芯片通过 scale-up 拼起来。
5. 批处理:Prefill/Midfill 排序,Decode 用小批(§15–16)
专家算术强度:
- n 是这个专家本次分到的 token 数;n 增大会摊薄权重加载,直到激活值搬运占主导。
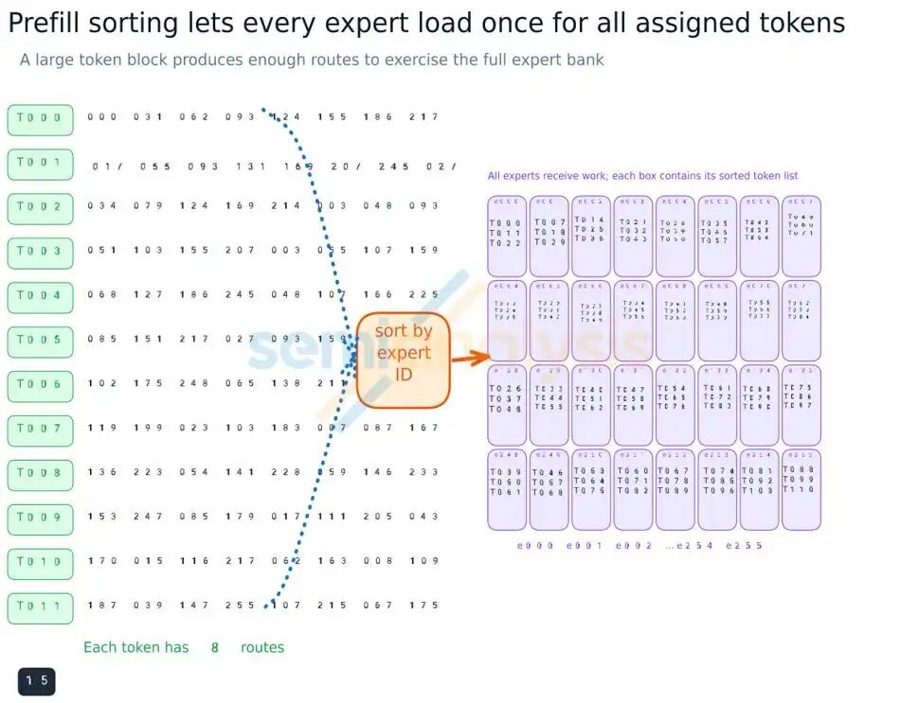
- 例子: 128 个 token × 每个 8 条路由 = 1,024 次指派,分到 256 个专家上。按专家排序后,每个专家只加载一次(图 20)。
- Decode 的批: 最佳 batch 往往只有 1–5。长上下文下 batch=1 就能把 HBM 带宽用满;扩大 batch 换来的吞吐不多,却会显著拉长时延并占满 KV 显存。
- 商业判断: 高交互 token 的价值是离线 token 的数倍甚至数十倍。
6. NVL72 和 SRAM 专家(§3 段落)
NVL72 为什么值得:
- 72 卡同频同步,一层 256 个专家可以分成每卡 3–4 个,读完本卡专家的时间很短。
- 代价是 72 卡之间有大量 all-to-all。
- 每卡驻留的专家越少,交互速率上限越高。
SRAM 专家 / DAF(注意力与 FFN 分离):
- SRAM 每字节读取能耗约为 HBM 的 1/100,单个 token 不用等批就能高效执行。
- 但连接数百个节点的交换网络会被 all-to-all 淹没,网络的成本和功耗可能超过专家算力本身。
7. 调度与控制(§17–18、§22)
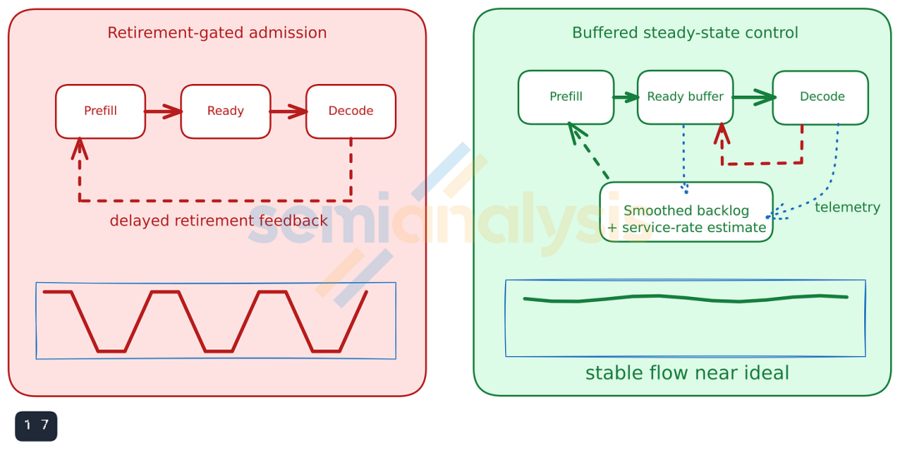
反面例子: 用 Decode 完成退役作为 Prefill 准入的信号。长尾请求会导致准入收紧 → Decode 断粮 → 报复性放开准入 → 再次拥堵,形成振荡(图 22)。
原文给出的对策:
- 阶段之间设就绪缓冲区;
- 用平滑后的积压量和预测服务速率做准入;
- 快控制环和慢的容量重分配分开;
- 拓扑重配置设迟滞阈值;
- 为交互流量预留容量;
- batch 调整频率不要快于反馈的时间常数。
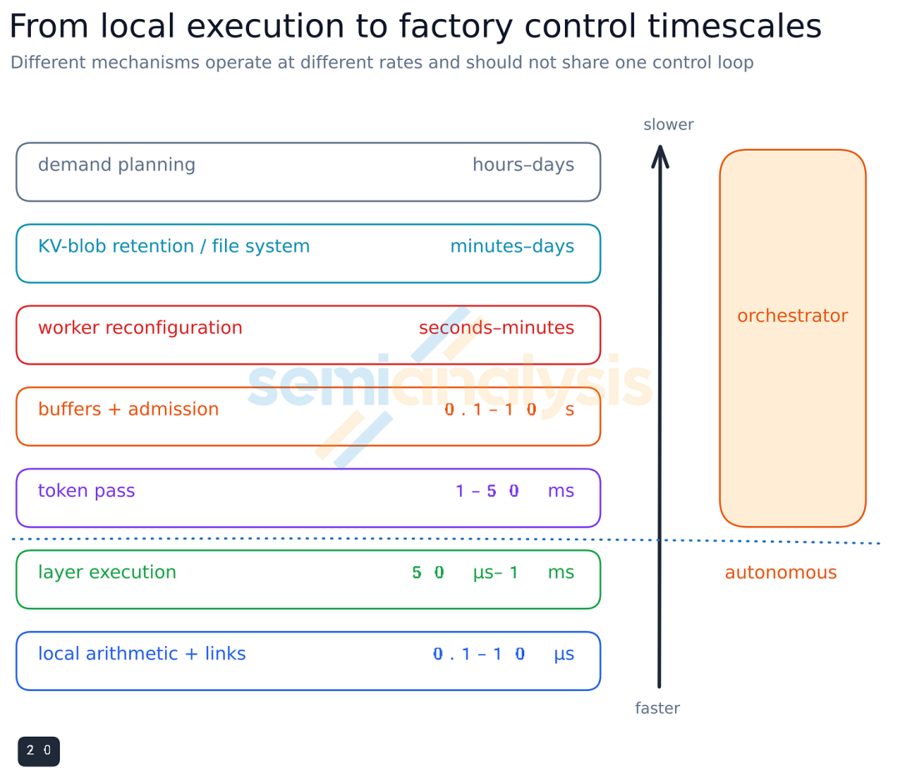
七个时间尺度(图 25):
| 尺度 | 内容 | 控制方 |
|---|---|---|
| 0.1–10 µs | 片上运算与链路 | 自治 |
| 50 µs–1 ms | 单层执行 | 自治 |
| 1–50 ms | 单个 token 生成 | 编排器 |
| 0.1–10 s | 缓冲与准入 | 编排器 |
| 秒–分钟 | Worker 重配置 | 编排器 |
| 分钟–天 | KV blob 生命周期 | 编排器 |
| 小时–天 | 容量规划 | 编排器 |
8. 聚合与解耦(§19)
聚合(单轮内 Prefill、Midfill、Decode 都在一台机器上完成)的好处:
- 没有调度间隙;
- 整套专家只需一份;
- KV 不过网络;
- 编排只需做一次决策。
代价: 机器必须同时有顶级算力、顶级显存带宽和顶级网络,任何一项有短板,都会在对应阶段变成”平庸”产品。
解耦: 允许 Prefill 机堆算力、Decode 机堆带宽。
作者的立场: 轮次之间的 KV 必须离开 HBM(卸载耗时小于 1 秒);单轮内部是否聚合,取决于能不能造出”全能芯片”。
9. 显存容量与带宽(§20)
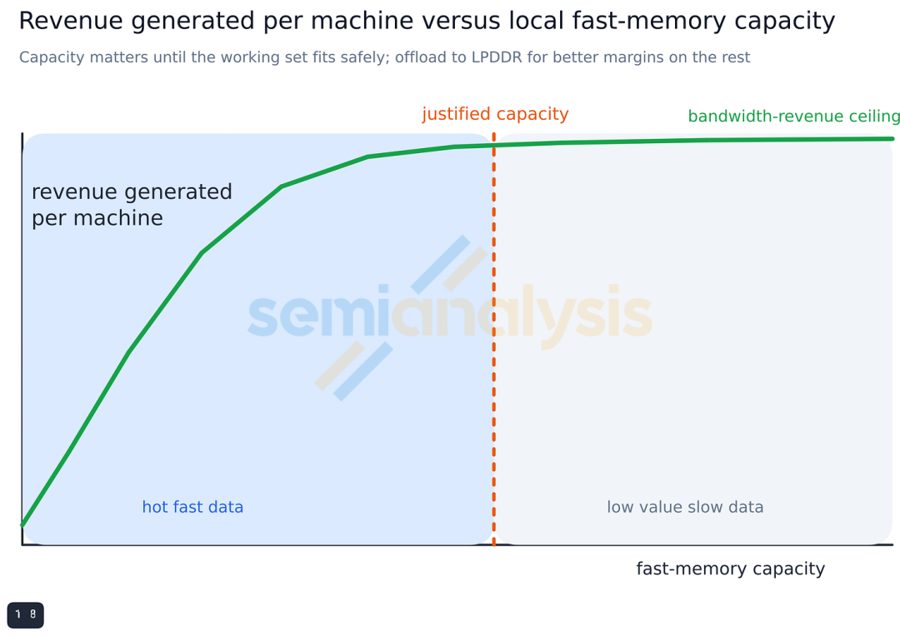
- 收益曲线(图 23): 单机营收随高速内存容量先陡升,过了”足够”的点后,碰到带宽决定的营收天花板,基本不再增长。
- 多余容量的副作用: 会诱导运营方为了摊销成本而用大 batch 跑低价离线 token,反而降低利润。
- 建议: 冷数据卸载到 LPDDR、DDR 或 SSD。
- 堆叠代价: 盲目增加 HBM 堆叠层数,会带来功耗、信号完整性和良率问题,以及降频。
三、Blackwell × Kimi K3 模拟结论(§23,图 26–29)
模拟配置:
- 硬件:A = GB200 NVL72,B = B200 SXM,C = B300 SXM;
- 负载:8k/32k 冷启动 Prefill,31k+1k 与 127k+1k Midfill,8k/32k/128k Decode,输出长度 1,000 token;
- 每张图上的连线是帕累托前沿。
| 维度 | 结论 |
|---|---|
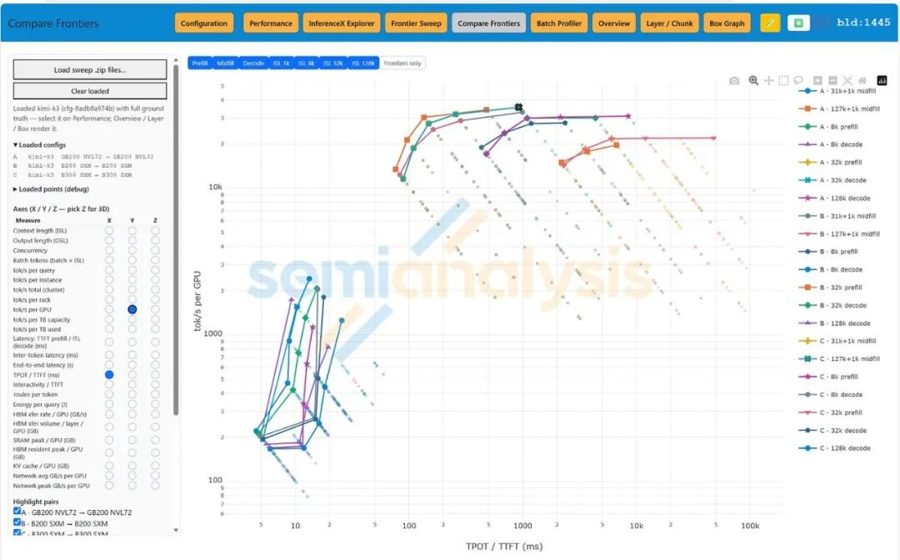
| 交互速率与吞吐(图 26) | Decode: 要最低时延,用 PP+TP;要单卡最高吞吐,用 TP=1、PP=1,EP 拉到硬件极限,GB200 在大部分区间领先。Midfill: GB200 不用 PP,用 TP 4 或 2,TTFT 最低;B200/B300 用 PP=4,EP 限制在 stage 内。Prefill: 三种芯片收敛到 PP=4 + TP 4 或 2,曲线几乎重合,由算力决定 |
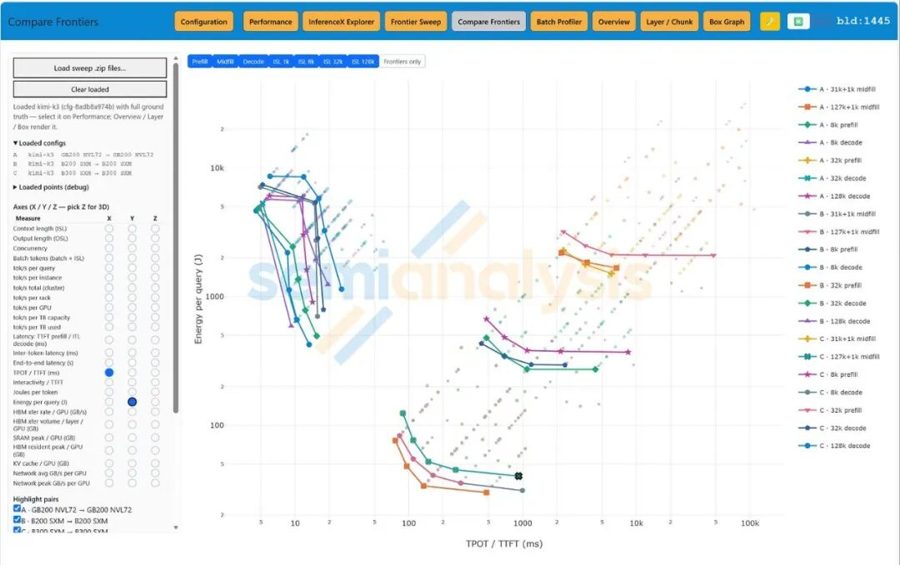
| 单次查询能耗(图 27) | Decode 能耗最高(1,000 token 要完整前向 1,000 次);Midfill 最低,一次前向就完成;Prefill 随输入长度阶梯上升 |
| 单卡峰值 HBM(图 28) | 前沿点大多低于 80 GB(不含双缓冲,双缓冲每卡还需额外数 GB)。Prefill/Midfill 靠 PP 降低显存,Decode 靠 TP/DP |
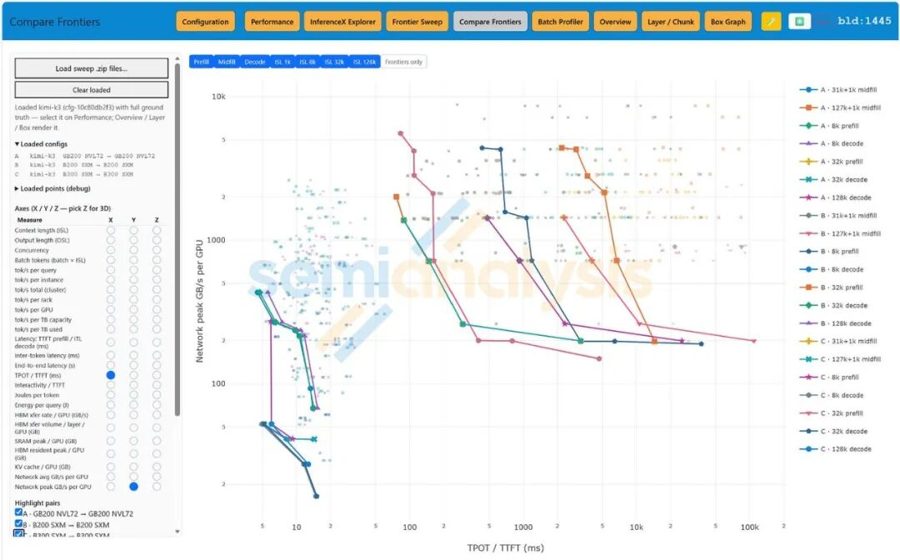
| 单卡峰值网络(图 29) | Prefill/Midfill 的 EP 流量最大:读图约数百到数千 GB/s。B200/B300 必须把一个 stage 关在一个 NVLink 节点内;NVL72 整机架都是 scale-up 域。Decode 的平均峰值较低,但单个包仍按链路线速突发,规划网络时要按瞬时峰值,不能按统计平均 |
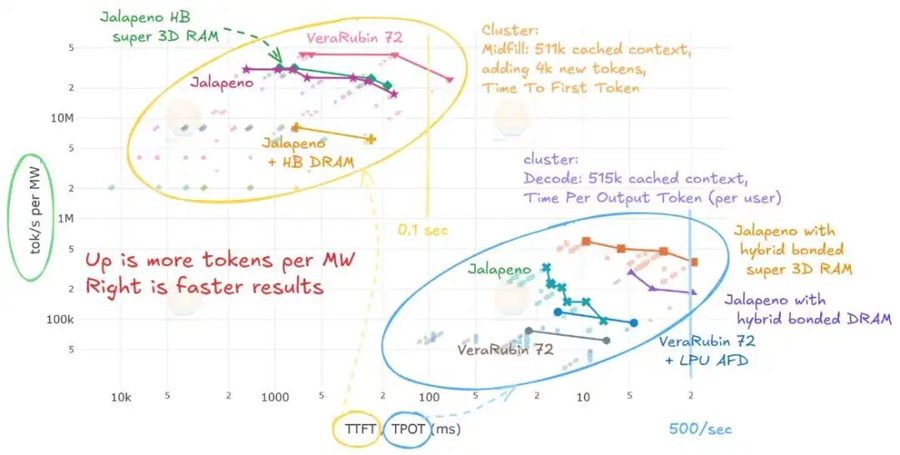
读图补充:图 7(未来内存的加速预测,50 万 token 缓存)
| 工况 | 方案 | 读图值 |
|---|---|---|
| Midfill(511k 缓存 + 4k 新 token),TTFT | Vera Rubin 72 | 最高,约 4–5×10⁷ tok/s/MW |
| Jalapeño;Jalapeño + HB super 3D RAM | 约 2–3×10⁷ | |
| Jalapeño + HB DRAM | 约 6–8×10⁶ | |
| Decode(515k 缓存),TPOT | Vera Rubin 72 | 约 6–8×10⁴ tok/s/MW |
| VR72 + LPU AFD | 约 1×10⁵,可延伸到约 2 ms/token(500 tok/s) | |
| Jalapeño | 约 1–3×10⁵ | |
| Jalapeño + 混合键合 super 3D RAM | 约 4–6×10⁵,最高,且在 2 ms TPOT 附近仍有工作点 |
说明:
- 这张图是 SemiAnalysis 的情景预测。“Jalapeño + 3D RAM”并不是已发布的产品。
- 图中意思:Midfill 是 Rubin 的强项;Decode 则是高带宽内存决定胜负。
四、图片缩影(29 张)
图片来源:SemiAnalysis 原文配图(经中文译文转载),这里只作为学习笔记的缩略引用。
A. 服务全景与 Agent 负载
| 图 | 内容 | 要点 |
|---|---|---|
| 1 | 解耦推理服务全景:请求队列 → Pre/Midfill 池 → 并行文件系统(KV blob 分片)→ Decode 池;编排器贯穿全程 | 四个资源池通过共享状态连接 |
| 2 | 393 段对话的上下文增长曲线(横轴为主 agent 轮次,纵轴为上下文长度,均为对数刻度) | 很快涨到 100k–1M,随后压缩回落 |
| 3 | 每轮的缓存上下文、未缓存输入、输出长度(区分主 agent 和子 agent) | 缓存约 10k–100k;新增输入约 100–10k;输出约 10–10k |
| 4 | 两段长对话:fable-5 共 2,977 轮,最大 989,824 token;opus-4-8 共 1,647 轮 | 接近上限时出现压缩台阶和骤降 |
B. KV 流动与阶段边界
| 图 | 内容 | 要点 |
|---|---|---|
| 5 | KV blob 在 文件系统 / NIC-RDMA / CPU DDR / HBM 之间流动(每颗 CPU 配 4–8 颗 GPU) | 输入直写 HBM;输出先进 DDR 暂存 |
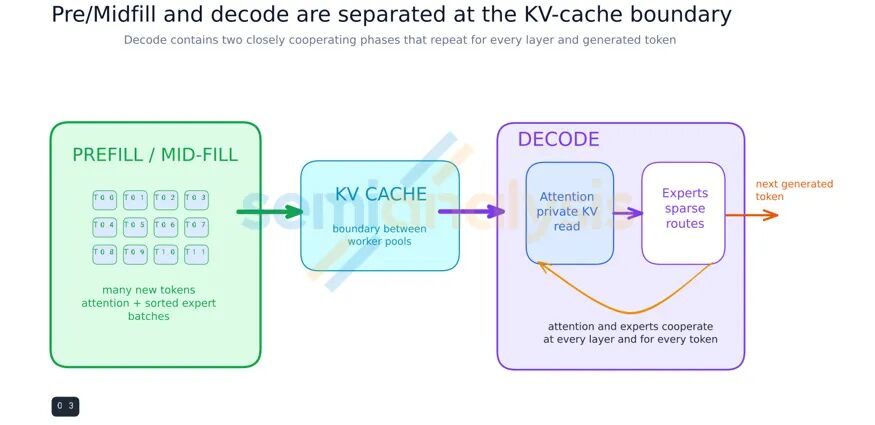
| 6 | Pre/Midfill 与 Decode 在 KV cache 处分界;Decode 内注意力与专家逐层配合 | 阶段边界就在 KV cache |
| 7 | 未来内存(混合键合 DRAM、3D RAM)的加速预测:Jalapeño 变体对比 Vera Rubin 72 和 LPU AFD | 见上文第三部分的读图表 |
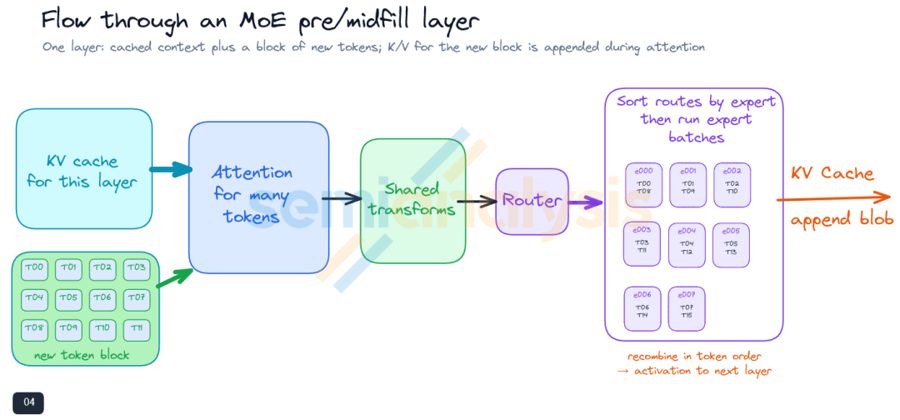
| 8 | MoE Pre/Midfill 层:注意力 → 共享变换 → 路由 → 按专家排序后成批 → 追加 KV blob | 按专家排序是关键 |
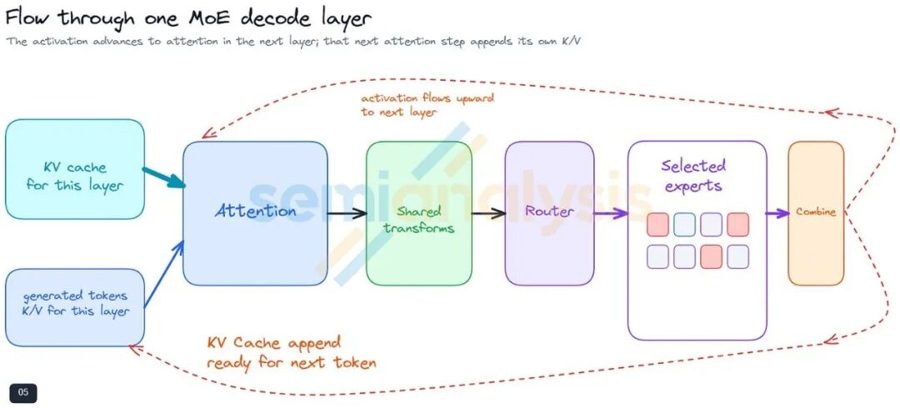
| 9 | MoE Decode 层:注意力 → 共享变换 → 路由 → 选中专家 → 合并 → 进入下一层 | 每层每个 token 循环一次 |
| 10 | Midfill Worker:长前缀读取 + 新后缀 → 专家排序成批 → 更新 KV blob → 交给 Decode 池 | Midfill 的 PP/TP/EP 最优配置不同于 Decode |
C. 模型结构到硬件的映射
| 图 | 内容 | 要点 |
|---|---|---|
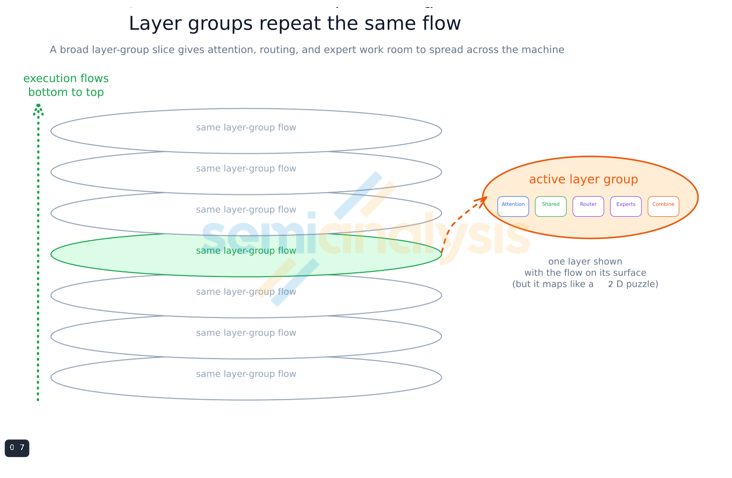
| 11 | 层组重复堆叠,执行从下往上走 | 一层就是一张”可丽饼” |
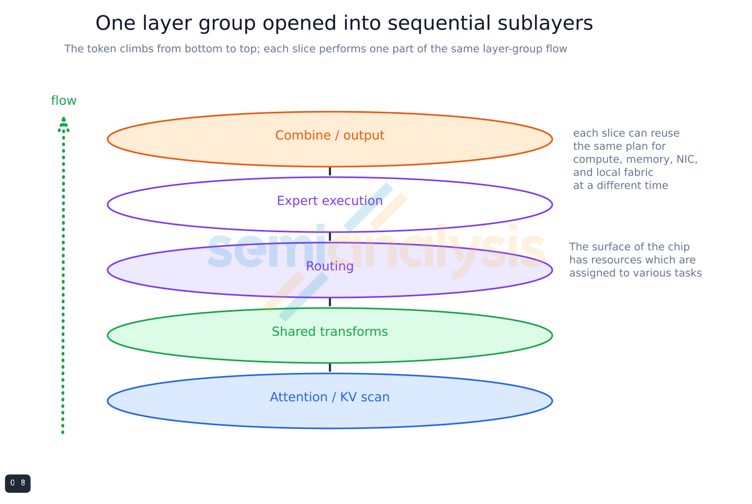
| 12 | 层组展开:注意力 / KV 扫描 → 共享变换 → 路由 → 专家 → 合并 | 各子层顺序执行 |
| 13 | TP 集合通信在层内;节点内多颗加速器之间是 EP 路由 | 内存加算力成对出现在每个 socket |
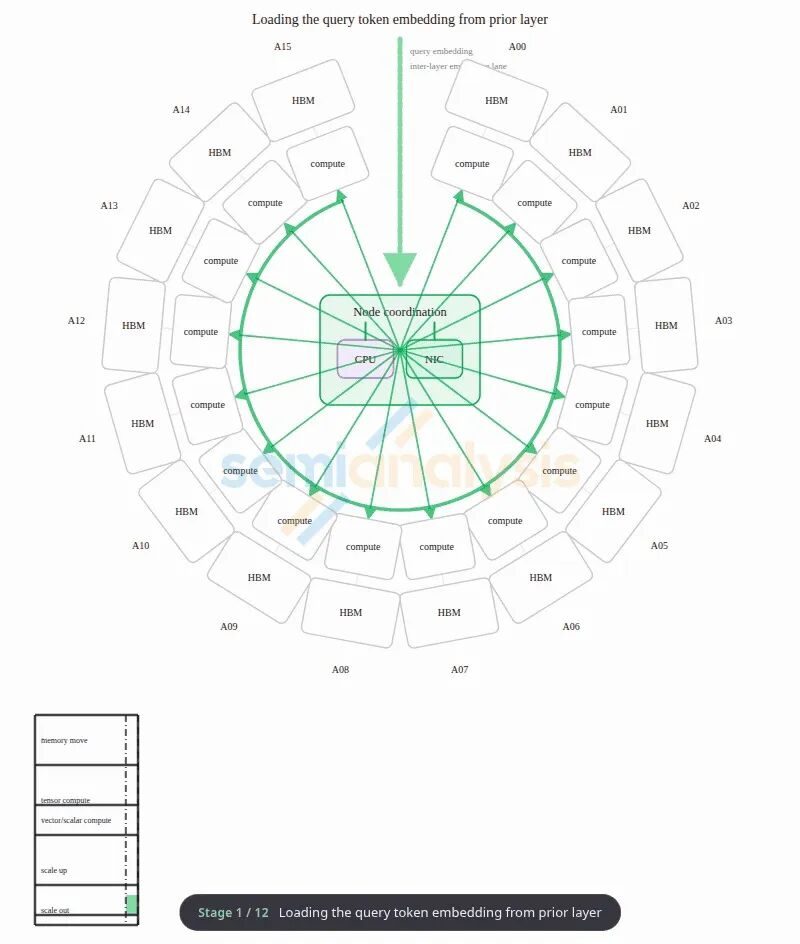
| 14 | 16 颗加速器的对等组位于 scale-up 网络上;CPU、NIC 负责协调;scale-out 承载 KV blob、流水线激活和任务分派 | 逻辑节点只是一个抽象 |
| 15 | 机架由重复节点堆成;scale-up 覆盖整个机架时,中间网络层消失 | 对应 NVL72 形态 |
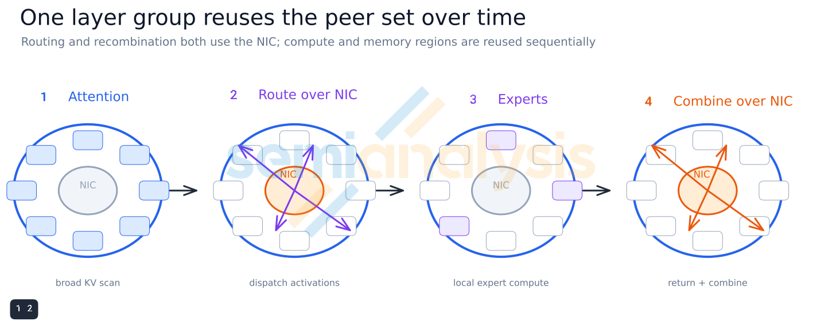
| 16 | 一个层组分时复用对等组:注意力 → 经 NIC 路由 → 专家 → 经 NIC 合并 | 同一硬件按时间分时使用 |
| 17 | 动态演示第 1 帧:从上一层加载 query embedding,按 memory / tensor / vector / scale-up / scale-out 分道显示(共 12 帧) | 微秒级流水线 |
| 18 | 4 个流水线 stage,每个含 2 个层组 | 按层组均匀切分 |
| 19 | 流水线越深,每 stage 权重越少,但 KV 与工作集不变 | KV 交叉点 |
D. 批处理、控制与方法论
| 图 | 内容 | 要点 |
|---|---|---|
| 20 | Prefill:12 个 token × 8 条路由,排序后每个专家都有活干 | 每个专家只加载一次 |
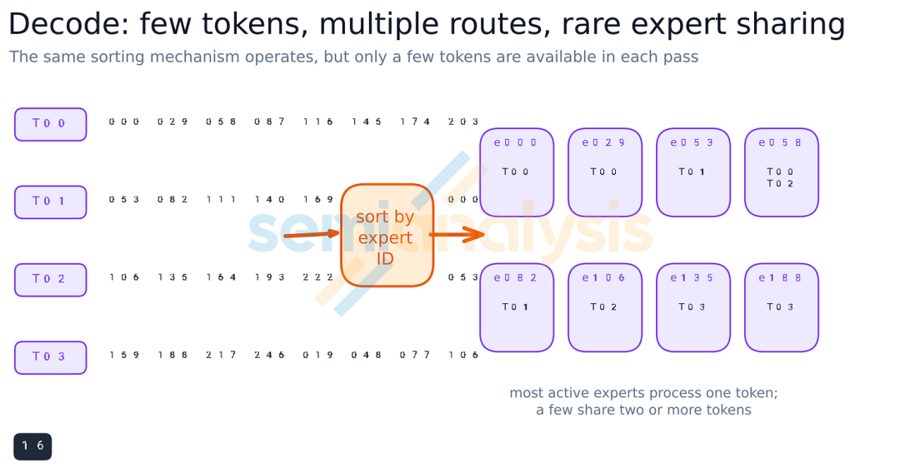
| 21 | Decode:4 个 token,多数专家只处理 1 个 token | 专家很少被共享 |
| 22 | 左:用退役信号控制准入导致振荡;右:缓冲加平滑积压控制,流量接近理想 | 控制工程方法 |
| 23 | 单机营收与高速内存容量的关系:越过”合理容量”后被带宽天花板封顶 | 容量够用即可 |
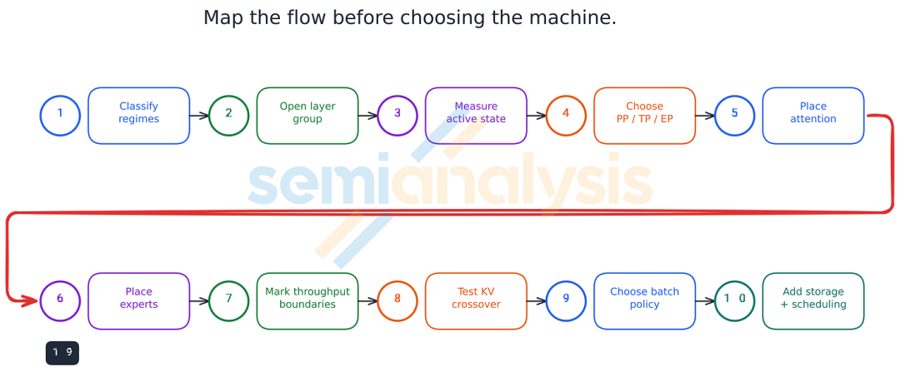
| 24 | 10 步方法论:分阶段 → 拆层组 → 盘点活跃状态 → 选 PP/TP/EP → 放注意力 → 放专家 → 标吞吐边界 → 测 KV 交叉点 → 定批策略 → 加存储与调度 | 先映射数据流,再选机器 |
| 25 | 七个时间尺度:0.1 µs 到天 | 不同控制环不要共用同一个信号 |
E. Blackwell × Kimi K3 模拟(SemiAnalysis 推理模拟器界面)
| 图 | 纵轴 | 要点 |
|---|---|---|
| 26 | 单卡 tok/s,对比 TPOT/TTFT | 不同阶段的前沿分成几簇,GB200 领先 |
| 27 | 单次查询能耗(J) | Decode 最耗能,Midfill 最省 |
| 28 | 单卡峰值 HBM 驻留(GB) | 大多数低于 80 GB |
| 29 | 单卡峰值网络(GB/s) | Prefill/Midfill 的 EP 流量最大,要关在 scale-up 域内 |
五、与我已有洞察的对照
| 话题 | 本文观点 | 我已有的判断 | 一致性 |
|---|---|---|---|
| 阶段拆分 | 四阶段,单独提出 Midfill,以解耦为主 | 流量调度报告按 PD 分离和多 Agent 分析,KV 命中率 ≥95% | 一致,并且更细。Midfill 可以作为 Agent 场景的主流工况,后续报告应补上这一阶段 |
| OpenAI Jalapeño | 图 7 把 Jalapeño 列为 Decode 能效高于 Vera Rubin 的方案,但 Midfill 不及 Rubin | Jalapeño 分析:带宽 / W 是 GB300 的 3.9 倍,FLOP/Byte 约 870,不做 PD 分离 | 互相印证:Jalapeño 押的是 Decode。它选择聚合,正好符合本文所说”聚合要求每一维都顶级”的难度,在 Midfill 上算力偏弱是它的代价 |
| scale-up 边界 | EP 和 TP 必须锁在 scale-up 域内,每跳 100 ns 都重要 | Jalapeño 本地 128 颗一跳、全局 rail 两跳;OpenAI 在 ECOC 上把时延和可靠性放在互连选型首位 | 一致。光学 scale-up 的时延预算(FEC、DSP、重定时)是硬约束 |
| 单卡显存 | 大多数前沿配置低于 80 GB,带宽比容量重要 | Jalapeño 216 GB,GB300 288 GB;SemiAnalysis 自己的算例也说每 stage 要 400–500 GB | 不矛盾:每 stage 400–500 GB 可以由多颗芯片拼成,单卡容量不必大。但”低于 80 GB”依赖 KV 能在 1 秒内被卸载,前提是后端存储网络足够强 |
| KV 搬运网络 | 数 GB 的 KV 走 scale-out,条带化,小于 1 秒 | 流量调度报告中的 KV 体积:Llama3-70B 约 320 KB/token,DeepSeek MLA 约 70 KB/token | 一致。前端和存储网络的带宽需求会随 Agent 负载上升(推算:100k 上下文 × 70 kB = 7 GB 每次迁移) |
| SRAM 专家 / DAF | 能效好 100 倍,但网络会成为瓶颈 | NVIDIA Groq 3 LPX(256 LPU/机架,RealScale) | 图 7 的 “VR72 + LPU AFD” 就是这条路线:Decode 能效提升有限,但能把交互速率推到 2 ms/token |
六、对光互连的含义
- scale-up 域的大小由 Prefill/Midfill 的 EP 峰值决定。
- 模拟中单卡峰值网络流量达到数百到数千 GB/s,而且是线速突发。
- 光学 scale-up 必须同时满足带宽和低于 100 ns 级的单跳增量时延,LPO、CPO 这类无 DSP 方案更有优势。
- scale-out 的角色变成”KV 物流网络”。
- KV blob 需要条带化、类 BT 并发、GPUDirect RDMA,单次数 GB,要求小于 1 秒完成。
- 前端和存储网络的带宽应按”并发 Agent 数 × 平均每轮 KV 迁移量”来规划,而不是按传统南北向流量。
- 推算示例:1 万个活跃会话,每轮 7 GB,每 10 秒迁移一次,约 7 TB/s,即约 56 Tb/s 的集群级存储流量。
- 按峰值规划,不按平均。
- Decode 的平均流量低,但包是突发的。光模块和交换缓存的利用率指标要看瞬时峰值。
- 新型内存会改变带宽和互连的比例。
- 混合键合 DRAM、3D RAM 会大幅提高 Decode 能效(图 7 约 2–4 倍)。
- 单卡带宽上去后,EP all-to-all 对 scale-up 带宽的需求会同比上升。
七、批判性评估
- 证据性质: 第三部分全部是 SemiAnalysis 模拟器的结果,图 7 是情景预测。模型 Kimi K3 的结构参数和模拟假设没有完整公开,只能当方向性判断。
- 立场: SemiAnalysis 同时经营 AgentX、InferenceX 和模拟器等商业产品,文中的数据集和工具都来自它自己。
- 偏向解耦: 全文以解耦为主线,对聚合的讨论偏理论。OpenAI Jalapeño 这类走聚合路线的系统在实测中的表现,仍需对照第三方数据。
- “低于 80 GB”的边界条件: 依赖高带宽存储网络、双缓冲和快速卸载,并且不含双缓冲占用。在长上下文、高并发的 Agent 场景下要谨慎外推。
- 译文质量: 中文译文有大量渲染性修辞,个别术语译法不统一(如 Midfill、对等组)。核对数字时建议回到英文原文。
八、后续跟踪
- 找到英文原文,核对 Kimi K3 参数和图 7、图 29 的确切数值;
- 在流量调度报告中补上 Midfill 阶段,以及 KV 物流网络的带宽估算;
- 关注 Jalapeño 是否会有采用 3D RAM 或混合键合 DRAM 的后续版本,以及 OpenAI 的 Midfill 策略;
- 关注 LPU AFD(注意力与 FFN 分离)的实际部署和网络开销。